Zbiór danych do dwuwymiarowego modelu probitowego powinien zawierać numeryczne zmienne objaśniające ( active/ active2/ active12) i binarne zmienne objaśniane (target i target2 ). Aby używać zmiennych kategorycznych jako zmiennych objaśniających należy przekształcić je na zmienne zerojedynkowe przy użyciu procedury do binaryzacji z włączoną opcją Random Redundant. Binaryzacja może być wykonana przed budową modelu albo podczas budowy dzięki wyborowi opcji Automatic Data Transformation w General Algorithm Settings.
Jeżeli nie wybrano opcji Automatic Data Transformation w General Algorithm Settings, brakujące wartości nie są wspierane przez moduł Dwuwymiarowy model probitowy. Innym sposobem na użycie zbioru danych z brakującymi wartościami jest zastąpienie braków przed budową modelu albo przełączenie na Liberal Mode w ustawieniach algorytmu w celu automatycznego pomijania obserwacji zawierających brakujące wartości. To wymaganie odnosi się również do zmiennej target w modelu cenzorowanym, ponieważ parametry tego modelu są szacowane przez model regresji logistycznej.
Aby zbudować dwuwymiarowy model probitowy, w obiekcie function settings funkcji dwuwymiarowej należy określić Target (nazwa targetu w równaniu domyślnym), Target2 (nazwa targetu w równaniu cenzorującym), 1st Target Positive Value i 2nd Target Positive Value (wartości pozytywne dla odpowiednich targetów). Dla zmiennej Target wartość pozytywna jest interpretowana w ten sam sposób, co dla modelu regresji logistycznej, a dla zmiennej Target2 wartość pozytywna oznacza, że dana obserwacja nie jest cenzorowana. Oba targety mogą być również określone przez ustawienie odpowiednich usage options w bieżącym AttributeusageSet: target dla targetu w równaniu domyślnym i target2 dla targetu w równaniu cenzorującym.
Zmienne, których wystąpienia oczekuje się w obu równaniach, powinny zostać ustawione na active12 w bieżącym AttributeUsageSet. Zmienne, które mają pojawić się tylko w równaniu domyślnym, powinny zostać ustawione na active w bieżącym AttributeUsageSet. Zmienne, które mają pojawić się tylko w równaniu cenzorującym, powinny zostać ustawione na active2 w bieżącym AttributeUsageSet.
Przykładowy skrypt znaleźć można w sekcji Przykłady (pełny kod źródłowy z danymi można znaleźć w załączniku przykładów).
Model budowany jest w standardowy w AdvancedMiner sposób. Pełna specyfikacja ustawień modelu zawiera następujące elementy: ogólne ustawienia algorytmu (General Algorithm Settings), ustawienia optymalizacji (Optimization Algorithm Settings), ustawienia doboru zmiennych (Variable Selection Settings) i ustawienia transformacji (Transformation Settings).
Możliwe jest również wykorzystanie opcji seedModel w obiekcie BivariateFunctionSettings w celu budowy modelu dwuwymiarowego w sposób przyrostowy, zaczynając od estymatora parametrów wybranego modelu źródłowego (ang. seed model). Jeżeli określono model źródłowy, wówczas są ignorowane opcje Preselection i Variable Selection Settings.
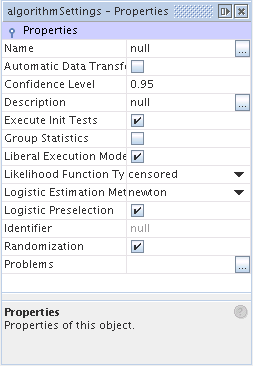
Algorytm dwuwymiarowego modelu probitowego jest kontrolowany przez następujące opcje:
Tabela 18.1. Moduł Dwuwymiarowy model probitowy: Algorithm Settings
| Nazwa | Opis | Możliwe wartości | Wartość domyślna |
|---|---|---|---|
| Automatic Data Transformations | TRUE: zostaną wykonane automatyczne transformacje danych (np. replaceMissing, binaryzacja). | TRUE / FALSE | FALSE |
| Confidence Level | Poziom ufności dla estymatorów przedziałowych parametrów modelu. | Liczby rzeczywiste z przedziału (0.5,1) | 0.95 |
| Execute Init Tests | TRUE: zostaną wykonane wstępne testy danych/tasku. | TRUE / FALSE | TRUE |
| Group Statistics | TRUE: zostaną wyliczone statystyki dla grup zmiennych. | TRUE / FALSE | TRUE |
| Liberal Execution Mode | TRUE: budowa modelu w trybie "liberalnym" (algorytm nie zatrzymuje się z powodu drobnych błędów). | TRUE / FALSE | TRUE |
| Likelihood Function Type | Czy budowany będzie pełny czy cenzorowany dwuwymiarowy model probitowy. | full / censored | censored |
| Logistic Estimation Method | Wybór algorytmu estymacji dla modelu regresji logistycznej używanego do preselekcji. | fisher / newton | fisher |
| Logistic Preselection | TRUE: algorytm wykona wstępną selekcję zmiennych przy użyciu dwóch dodatkowych modeli logistycznych. | TRUE / FALSE | TRUE |
| Randomization | TRUE: optymalizacja funkcji wiarygodności algorytmem symulowanego wyżarzania. | TRUE / FALSE | TRUE |
- Likelihood Function Type
Jeżeli wybrano opcję full, zbudowany zostanie pełny dwuwymiarowy model probitowy. Jeżeli wybrano opcję censored, zostanie zbudowany dwuwymiarowy model probitowy z częściową obserwowalnością, tj. taki, w którym wartość zmiennej target jest obserwowalna tylko wówczas, gdy wartość zmiennej target2 jest pozytywna (równa wartości 2nd Target Positive Value określonej w BivariateFunctionSettings).
- Randomization
Jeżeli opcję tę ustawiono na FALSE, wykonywany jest standardowy algorytm Newtona-Raphsona (z ograniczeniami na współczynnik korelacji). Jeżeli opcję ustawiono na TRUE, wówczas wykonywany jest algorytm Newtona-Raphsona z dodatkową heurystyką symulowanego wyżarzania. Argumentem przemawiającym za wykorzystaniem symulowanego wyżarzania jest fakt, że funkcja wiarygodności w dwuwymiarowym modelu probitowym nie jest funkcją wypukłą, a co za tym idzie zwykły algorytm Newtona-Raphsona może czasami wskazać maksimum lokalne. Aby temu zapobiec, dopuszczalny jest mały losowy krok "w dół" z prawdopodobieństwem proporcjonanym do różnicy między obecną i nową (tj. niższą) wartością funkcji wiarygodności.
Notatka
Algorytm Newtona-Raphsona z włączoną opcją Randomization jest algorytmem randomizowanym. Z tego powodu jego zachowanie (a w szczególności liczba iteracji przed zbiegnięciem do optimum) może różnić się dla różnych uruchomień. Zalecane jest wykorzystanie modelu źródłowego (seedModel).
W uzupełnieniu ustawień specyficznych dla algorytmu dwuwymiarowego modelu probitowego, użytkownik może modyfikować:
Variable Selection Settings (ustawienia selekcji zmiennych) - aby kontrolować zachowanie dostępnych heurystyk budowy modelu; te ustawienia są opisane w rozdziale Automatyczna selekcja zmiennych.
Optimization Algorithm Settings (ustawienia optymalizacji) - aby kontrolować wybór algorytmu optymalizacyjnego; te ustawienia są opisane w rozdziale Biblioteka algorytmów optymalizacji.
Transformation Settings (ustawienia transformacji) - aby kontrolować sposób transformacji danych; te ustawienia są opisane w rozdziale Transformacja danych.
Uwagi
Inaczej niż w innych modułach statystycznych systemu AdvancedMiner, selekcja zmiennych w module Dwuwymiarowy model probitowy odnosi się tylko do preselekcji zmiennych do głównego dwuwymiarowego modelu probitowego. Preselekcja polega na niezależnej estymacji dwóch dodatkowych modeli logistycznych (jednego dla każdego równania). Zmienne istotne (z uwzględnieniem progów Kryterium wejścia and Kryterium wyjścia) stają się zmiennymi objaśniającymi w modelu dwuwymiarowym. Następnie budowany jest właściwy model dwuwymiarowy (bez kolejnego etapu selekcji zmiennych).
Wszystkie metody selekcji zmiennych uwzględniają jedynie zmienne oznaczone jako active lub active12 dla pierwszego dodatkowego modelu logistycznego (który dokonuje preestymacji parametrów równania domyślnego), oraz active2 lub active12 dla drugiego dodatkowego modelu logistycznego (który dokonuje preestymacji parametrów równania cenzorującego).
W przypadku algorytmu dwuwymiarowego probitu, następujące opcje selekcji zmiennych dostępne dla użytkownika nie wpływają na ostateczne ustawienia algorytmu, używane podczas fazy estymacji:
- Auxiliary Lift Estimation Mode,
- Group Mode
Jest to spowodowane specyfiką algorytmu dwuwymiarowego probitu, który nie w pełni jest dopasowany do modułu Selekcji zmiennych.
Końcowy model zawiera następujące statystyki: Variable Statistics, Group Statistics (tylko jeżeli wybrano opcję Group Statistics), Model Fit Statistics, Coefficient Correlation oraz Covariance Matrices i Attributes Correlation Matrix.
Tabela 18.2. Statystyki dwuwymiarowego modelu probitowego: Variable Statistics
| Nazwa | Opis |
|---|---|
| Coeff | Oszacowana wartość parametru. |
| Lower Confidence | Dolna granica przedziału ufności dla estymatora. Przedział ufności jest wyliczany dla poziomu ufności określonego w bieżących ustawieniach algorytmu (por. opcję Confidence Level ). |
| Pr(Wald>ChiSq) | Wartość p-value dla statystyki Walda dla estymatora parametru. Statystyka jest testowana na zgodność z rozkładem chi-kwadrat o jednym stopniu swobody. |
| StdErr | Błąd standardowy estymatora parametru. |
| Upper Confidence | Górna granica przedziału ufności dla estymatora. Przedział ufności jest wyliczany dla poziomu ufności określonego w bieżących ustawieniach algorytmu (por. opcję Confidence Level ). |
| Variable | Nazwa zmiennej (poprzedzona '0. ' dla zmiennych w równaniu domyślnym albo '1. ' dla zmiennych w równaniu cenzorowanym). Współczynnik korelacji (ang. Correlation coefficient) nazwany jest 'RO'. |
| Wald Test | Wartość statystyki Walda dla estymatora parametru. |
Tabela 18.3. Statystyki dwuwymiarowego modelu probitowego: Group Statistics
| Nazwa | Opis | |
|---|---|---|
| Variable | Nazwa zmiennej. | |
| DF | Liczba stopni swobody zmiennej albo grupy zmiennych; dla algorytmu dwuwymiarowego probitu jest zawsze DF = 1 (por. Uwagi) | |
| Wald Stat | Wartość statystyki Walda. | |
| Wald Pr>ChiSq | Wartość p-value dla statystyki Walda. |
Tabela 18.4. Statystyki dwuwymiarowego modelu probitowego: Model Statistics
| Nazwa | Opis |
|---|---|
| Likelihood Ratio Stat | Wartość statystyki współczynnika wiarygodności. |
| Pr(LRatio>ChiSq) | Wartość p-value dla statystyki współczynnika wiarygodności. Statystyka jest testowana na zgodność z rozkładem chi-kwadrat o p stopniach swobody, gdzie p jest liczbą atrybutów w końcowym modelu. |
| Pr(Score>ChiSq) | Wartość p-value dla statystyki score'u. Statystyka jest testowana na zgodność z rozkładem chi-kwadrat o p stopniach swobody, gdzie p jest liczbą atrybutów w końcowym modelu. |
| Pr(Wald>ChiSq) | Wartość p-value dla statystyki Walda. Statystyka jest testowana na zgodność z rozkładem chi-kwadrat o p stopniach swobody, gdzie p jest liczbą atrybutów w końcowym modelu. |
| Score Stat | Wartość statystyki score'u . |
| Wald Stat | Wartość statystyki Walda. |
| Zero Correlation Stat | Statystyka do testu hipotezy o zerowej korelacji. |
| Pr(ZeroCorr>ChiSq) | Wartość p-value statystyki zerowej korelacji. Statystyka jest testowana na zgodność z rozkładem chi-kwadrat z jednym stopniem swobody. |
| ZeroCorr Sample | Rozmiar próbki użytej do testu hipotezy o zerowej korelacji. |
| Covariance | Macierz kowariancji estymatorów parametrów. |
| Correlation | Macierz korelacji estymatorów parametrów. |
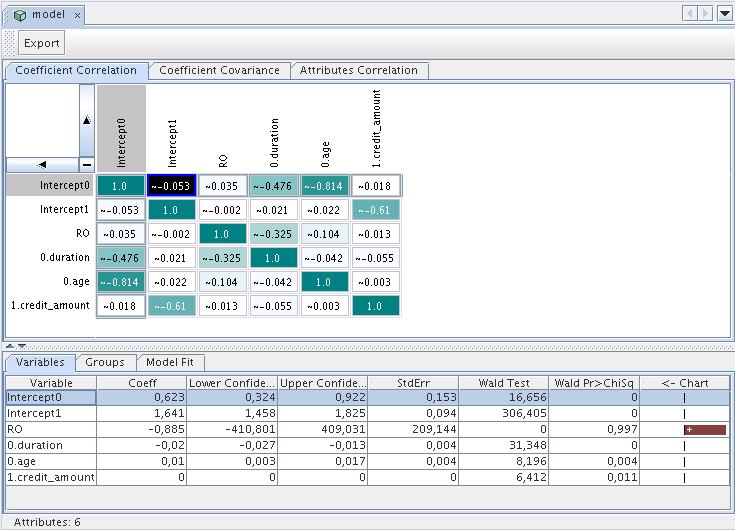
- Kowariancja
Macierz kowariancji estymatorów parametrów obliczana jest jako
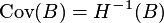
gdzie
 jest Hesjanem
estymatorów parametrów.
- Correlation
Macierz korelacji estymatorów parametrów obliczana jest jako
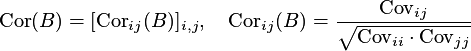
gdzie
 jest
 -tym elementem macierzy kowariancji
estymatorów parametrów.
- Statystyka współczynnika wiarygodności (Likelihood Ratio)
Statystyka współczynnika wiarygodności wyliczana jest jako:
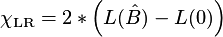
- Statystyka score'u
Statystyka score'u wyliczana jest jako:
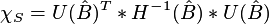
gdzie
 jest gradientem
logarytmu funkcji wiarygodności.
- Statystyka Walda
Statystyka Walda wyliczana jest jako:
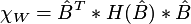
Statystyka Walda dla estymatora parametru jest definiowana jako:
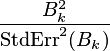
gdzie
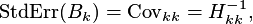 a
 oznacza Hesjan
(macierz drugich pochodnych cząstkowych logarytmu funkcji wiarygodności)
oraz
 oznacza gradient
logarytmu funkcji wiarygodności (obie macierze
wyliczone dla estymatora największej wiarygodności (ang. MLE).
Dwuwymiarowy model probitowy może być stosowany do problemu klasyfikacji w podobny sposób co model regresji logistycznej. Klasyfikacja jest oparta o oszacowane prawdopodobieństwa i ustalone prawdopodobieństwo progowe. Obserwacja (wektor wartości atrybutów) jest zaliczana do jednej z dwóch grup na podstawie porównania warunkowego prawdopodobieństwa wyliczonego dla tej obserwacji z modelu oraz prawdopodobieństwa progowego (por. również przykład).
Przy klasyfikacji danych moduł Dwuwymiarowy model probitowy może generować dwa rodzaje wyniku: kategorię lub prawdopodobieństwo. W celu zapoznania się ze szczegółami stosowania modelu do danych por. rozdział Zastosowanie modeli w systemie AdvancedMiner i część poświęconą Klasyfikacji w sekcji Zastosowanie do różnych funkcji data-miningowych.
Tabela poniżej prezentuje możliwe kombinacje i opisy rodzajów wyniku i typów obiektu wyniku.
Tabela 18.5. Kombinacje rodzajów wyniku i typów obiektu wyniku
| Rodzaj wyniku | Typ obiektu wyniku | Opis |
|---|---|---|
| probability | ranking | zwraca prawdopodobieństwo dla n-tej najbardziej prawdopodobnej kategorii zmiennej target w równaniu domyślnym |
| probability | category | zwraca prawdopodobieństwo zaklasyfikowania jako dana kategoria zmiennej target w default equation |
| category | rank | zwraca n-tą najbardziej prawdopodobną kategorię zmiennej target w równaniu domyślnym |
| category | kategoria | nie wspierane |
| nodeID | ranking | nie wspierane |
| nodeID | kategoria | nie wspierane |