Większość metod selekcji zmiennych oparta jest na porównywaniu modelu zawierającego daną zmienną z modelem nie zawierającym tej zmiennej. Jedynie algorytm Best Subset szacuje wszystkie możliwe dla danego zbioru zmiennych modele i ocenia je na podstawie współczynnika scoring value poszczególnego modelu.
Test oceniający czy dana zmienna powinna być włączona lub wyłączona z modelu w przypadku modeli takich jak ( Regresja logistyczna , Analiza przeżycia, Dwuwymiarowy model probitowy i Analiza szeregów czasowych ) jest oparty o statystykę wiarygodności (Likelihood Ratio) o rozkładzie zbliżonym do rozkładu chi-kwadrat z jednym stopniem swobody. Dla włączenia zmiennej jest ona równa
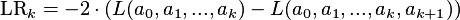
natomiast dla wyłączenia zmiennej wynosi
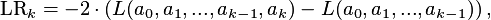
gdzie L jest maksimum funkcji wiarygodności danego modelu.
Test oceniający czy dana zmienna powinna być włączona lub wyłączona z modelu dla Regresji liniowej jest oparty o współczynnik dopasowania średniokwadratowego (statystyka Type2SS). Dla włączenia zmiennej jest on równy
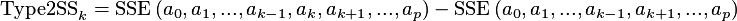
natomiast dla wyłączenia zmiennej wynosi
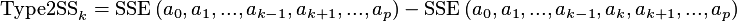
gdzie SSE jest sumą kwadratów reszt danego modelu.
Obie statystyki oceniają więc istotność zmiennej na podstawie zmiany tzw. scoring value modelu wiążącej się z dodaniem lub usunięciem zmiennej z modelu. W przypadku modeli Regresji logistycznej, każdy z modeli jest oceniany na podstawie sumy kwadratów reszt (SSE), a w przypadku modeli opartych o funkcję wiarygodności - na podstawie maksimum tej funkcji dla modelu.
Niezależnie od wybranej metody selekcji zmiennych, końcowy model zawsze będzie zawierał wszystkie zmienne oznaczone jako obligatory (konieczne) i żadnej ze zmiennych oznaczonych jako inactive (nieaktywne).
Dla modeli Regresji liniowej, Regresji logistycznej, Szeregów czasowych i Analizy przeżycia wszystkie sposoby selekcji zmiennych uwzględniają wyłącznie zmienne oznaczone jako active (aktywne) w obiekcie function settings modelu.
Inaczej niż w przypadku powyższych modeli, dla Dwuwymiarowego modelu probitowego selekcja zmiennych sprowadza się jedynie do preselekcji zmiennych do głównego modelu. Preselekcja oznacza dobór zmiennych niezależnie do każdego z dwóch modeli cząstkowych. Zmienne, które są istotne (ocena na podstawie kryterium wejścia (Model Entry Level) i kryterium wyjścia (Model Leave Level)) stają się zmiennymi objaśniającymi w końcowym modelu dwuwymiarowym. Model końcowy budowany jest już bez kolejnej selekcji zmiennych.
W tym przypadku, wszystkie metody selekcji zmiennych uwzględniają tylko zmienne oznaczone jako active lub active12 dla pierwszego z modeli cząstkowych (który dokonuje preestymacji współczynników równania domyślnego (default equation)) oraz active2 lub active12 dla drugiego modelu cząstkowego (który preestymuje współczynniki równania cenzorującego (censoring equation)).
Model pełny jest opcją domyślną, w przypadku której nie jest wykonywana żadna automatyczna selekcja zmiennych. Końcowy model zawiera wszystkie zmienne oznaczone jako active (aktywne) lub obligatory (konieczne) w obiekcie function settings modelu i nie zawiera żadnych zmiennych oznaczonych jako inactive (nieaktywne).
Na początku algorytmu Forward Selection w modelu nie ma żadnej zmiennej oznaczonej jako active, są natomiast wszystkie zmienne oznaczone jako obligatory (oraz dodatkowa stała, jeżeli w obiekcie Algorithm Settings zaznaczono opcję Intercept). Zmienne oznaczone jako active są kolejno dodawane do modelu według malejącej wartości statystyki resztowej (Residual Statistic) (i rosnącego p-value dla tej statystyki). W każdym kroku do modelu dodawana jest ta zmienna, której statystyka resztowa ma najmniejsze p-value. Zmienne są dodawane dopóty, dopóki p-value jest mniejsze od określonej wartości maksymalnej (Kryterium wejścia (Model Entry Level)).
Algorytm kończy się, kiedy dodanie dowolnej z pozostałych zmiennych aktywnych (active) powoduje, że p-value jest większe niż Kryterium wejścia (Model Entry Level).
Metoda ta ma dwa ograniczenia. Niektóre ze zmiennych nigdy nie trafiają do modelu, przez co ich istotność nie jest nigdy określona. Drugim ograniczeniem jest to, że zmienna, która została dodana do modelu, pozostaje w nim już do końca algorytmu, nawet jeśli utraciła istotność po dodaniu innych zmiennych.
Na początku algorytmu Backward Elimination w modelu są wszystkie zmienne active i obligatory. W jego trakcie kolejno usuwane są zmienne active. Dla każdej ze zmiennych wyliczana jest wartość statystyki resztowej (Residual Statistic) (i p-value dla tej statystyki). Zmienna, dla której p-value jest największa i większa niż Kryterium wyjścia (Model Leave Level) jest uznawana za najmniej użyteczną i opuszcza model.
Algorytm kończy się, kiedy żadna ze zmiennych active nie może być już usunięta (p-value dla wszystkich zmiennych w modelu są mniejsze niż Kryterium wyjścia). Zmienne oznaczone na wstępie jako obligatory zawsze zostają w modelu.
Ograniczeniem tej metody jest to, że model może zawierać silnie skorelowane zmienne i estymacja modelu pełnego (w pierwszym kroku) może być niemożliwa.
Algorytm Stepwise jest modyfikacją algorytmu Forward Selection i zaczyna się krokiem "forward". W każdym kroku tego algorytmu, po tym jak do modelu trafiła nowa zmienna, dla wszystkich zmiennych z modelu wyznaczana jest wartość statystyki resztowej (Residual Statistic) (i p-value dla tej statystyki). Jeżeli największe spośród p-value jest większe niż Kryterium wyjścia (Model Leave Level), dana zmienna jest usuwana z modelu. Po przetestowaniu włączonych do modelu zmiennych pod kątem usunięcia, wyłączone zmienne są ponownie badane pod kątem dodania ich do modelu.
W każdym kroku procesu może nastąpić co najwyżej jedno dołączenie zmiennej (krok "forward"), po którym następuje jedno lub więcej wykluczeń (krok "backward"). Algorytm zatrzymuje się, kiedy do modelu nie może być dodana już żadna zmienna (ze względu na Kryterium wejścia (Model Entry Level)) lub kiedy jedyną dostępną zmienną jest zmienna właśnie wyłączona z modelu. Zmienne oznaczone jako obligatory zawsze pozostają w modelu.
Algorytm Best Subset analizuje wszystkie możliwe podzbiory zmiennych w modelu. Podzbiory są przetwarzane od najmniejszego do największego. Dla każdego rozmiaru (tj. liczby zmiennych w modelu) najlepszy model (wg odpowiedniej statystyki scoringowej) jest odnotowywany w panelu Model Statistics. Jeżeli przy estymacji określono maksymalny rozmiar modelu (Max Model Size), algorytm Best Subset zwraca najlepszy model tego rozmiaru (por. również uwagi pod opisem opcji Max Model Size). W przeciwnym wypadku algorytm zwraca model zawierający wszystkie zmienne oznaczone jako active lub obligatory w obiekcie function settings (tj. taki sam model, co metoda Modelu pełnego).
Maksymalna dozwolna liczba zmiennych active dla algorytmu Best Subset jest równa 30, a w praktyce zaleca się wybór mniejszej ich liczby (nie więcej niż 10). Jest to spowodowane bardzo wysokimi kosztami obliczeniowymi tej metody (wzrastają wykładniczo wraz z liczbą zmiennych active).
Postęp algorytmu Best Subset jest wyświetlany w logu AdvancedMiner po estymacji każdych kolejnych 50 modeli. Widoczny jest również na pasku postępu w prawym dolnym rogu aplikacji. Jeżeli proces zostanie przerwany, najlepsze modele znalezione do tej pory dla każdego rozmiaru modelu będą zaprezentowane w Model Statistics.