Zbiór danych do konstrukcji szeregu czasowego powinien zawierać numeryczny target (z wartościami szeregu czasowego) oraz atrybut zawierający identyfikator punktu czasowego, używany do uporządkowania wartości szeregu. Nazwa tego atrybutu musi zostać określona w obiekcie Function settings dla modelu. Dla modelu MGARCH(p,q) dodatkowe zmienne objaśniające (predyktory) również powinny być numeryczne. Aby użyć zmiennych kategorycznych, konieczna jest ich transformacja do pomocniczych zmiennych zerojedynkowych.
Jeżeli nie wybrano opcji Automatic Data Trasformation, brakujące wartości (missing values) nie są wspierane przez moduł Szeregi czasowe. Innym sposobem użycia do modelowania zbioru zawierającego brakujące wartości jest ich uzupełnienie przed modelowaniem albo ustawienie Liberal Mode we właściwościach algorytmu (co zapewni automatyczne pominięcie obserwacji zawierających brakujące wartości).
Budowa modelu odbywa się w standardowy dla AdvancedMiner sposób, a cała procedura jest opisana w rozdziale AdvancedMiner w praktyce. Obiektem Function Settings dedykowanym do analizy szeregów czasowych jest TimeSeriesFunctionSettings. AlgorithmSettings są dodawane po dodaniu LogicalData. W zależności od tego, jaki model użytkownik chce utworzyć, dostępne są dwa typy obiektu AlgorithmSettings: ARCHSettings i GARCHSettings. Następnie, w oknie Properties obiektu TimeSeriesFuctionSettings ustawiane są dwie podstawowe właściwości: Target - nazwa zmiennej objaśnianej oraz Time Point Attribute Name nazwa zmiennej z identyfikatorem punktów czasowych. Opcja Sorting Required określa, czy potrzebne jest sortowanie wg zmiennej czasowej.
Pełna specyfikacja ustawień modelu zawiera elementy AlgorithmSettings: General Algorithm Settings, Optimization Algorithm Settings, Variable Selection Settings i Transformation Settings.
Tabela 30.1. Szeregi czasowe: ogólne ustawienia (Algorithm Settings)
| Nazwa | Opis | Możliwe wartości | Wartość domyślna |
|---|---|---|---|
| Autocorrelation Test Span | Liczba punktów czasowych w próbce, jaka zostanie użyta do utworzenia wykresów autokorelacji i autokorelacji cząstkowej. | Dodatnie liczby całkowite. | 10 |
| P | Parametr p modelu GARCH(p,q). | Dodatnie liczby całkowite. | 1 |
| Q | Parametr q modeli ARCH(q) i GARCH(p,q). | Dodatnie liczby całkowite. | 1 |
| Automatic Data Transformations | TRUE: zostaną wykonane automatyczne transformacje danych (np. replaceMissing, binaryzacja). FALSE: operacje te nie zostaną wykonane. | TRUE / FALSE | FALSE |
| Confidence Level | Poziom ufności dla wyliczenia estymatorów przedziałowych dla parametrów modelu. | Liczby rzeczywiste z przedziału (0,1). | 0.95 |
| Execute Init Tests | TRUE: zostaną przeprowadzono wstępne testy danych/tasku. | TRUE / FALSE | TRUE |
| Group Statistics | TRUE: zostaną wyliczone statystyki dla grup zmiennych. FALSE: nie zostaną wyliczone. | TRUE / FALSE | FALSE |
| Intercept | TRUE: model z wyrazem wolnym. FALSE: model bez wyrazu wolnego. | TRUE / FALSE | TRUE |
| Liberal Execution Mode | TRUE: budowa modelu w trybie "liberalnym" (proces nie zatrzymuje się na mniejszych błędach). | TRUE / FALSE | TRUE |
| Preselection | TRUE: zostaną wyliczone jednowymiarowe statystyki p-value. | TRUE / FALSE | FALSE |
Oprócz ustawień specyficznych dla modułu Szeregów czasowych, użytkownik może użyć:
Variable Selection Settings - aby kontrolować przebieg dostępnych algorytmów budowy modelu; ustawienia te są opisane w rozdziale Automatic Variable Selection.
Optimization Algorithm Settings - aby wybrać algorytm optymalizacji; te ustawienia są opisane w rozdziale Optimization Library.
Transformation Settings - aby kontrolować przekształcenia, jakim poddawane są dane. Te ustawienia opisane są w rozdziale Transformation.
Tabela 30.2. Statystyki modelu szeregu czasowego: Variables Statistics
| Nazwa | Opis |
|---|---|
| Coeff | Wartość oszacowanego parametru. |
| Univariate Pr>ChiSq | Wartość p-value dla statystyki współczynnika wiarygodności dla modelu jednowymiarowego. Ta statystyka jest wyliczana tylko wtedy, gdy w ustawieniach algorytmu wybrano opcję Preselection. |
| Lower Confidence | Dolna granica przedziału ufności dla estymatora. Przedział ufności jest wyliczany dla poziomu ufności określonego w ustawieniach algorytmu (por. opcję Confidence Level). |
| Upper Confidence | Górna granica przedziału ufności dla estymatora. Przedział ufności jest wyliczany dla poziomu ufności określonego w ustawieniach algorytmu (por. opcję Confidence Level). |
| StdErr | Błąd standardowy estymatora parametru. |
| Wald Test | Statystyka Walda dla estymatora parametru. |
| Pr(Wald>ChiSq) | Wartość p-value dla statystyki Walda dla estymatora parametru. Statystyka jest testowana na zgodność z rozkładem chi-kwadrat o jednym stopniu swobody. |
Tabela 30.3. Statystyki modelu szeregu czasowego: Model Statistics
| Nazwa | Opis |
|---|---|
| Likelihood Ratio Stat | Wartość statystyki współczynnika wiarygodności (ang. Likelihood Ratio) |
| Pr(LRatio>ChiSq) | Wartość p-value dla współczynnika wiarygodności. Statystyka jest testowana na zgodność z rozkładem chi-kwadrat o p stopniach swobody (gdzie p jest liczbą atrybutów w modelu końcowym). |
| Score Stat | Wartość statystyki score'u (and. score statistic) |
| Pr(Score>ChiSq) | Wartość p-value dla statystyki score'u. Statystyka jest testowana na zgodność z rozkładem chi-kwadrat o p stopniach swobody (gdzie p jest liczbą atrybutów w modelu końcowym). |
| Wald Stat | Wartość statystyki Walda |
| Pr(Wald>ChiSq) | Wartość p-value dla statystyki Walda. Statystyka jest testowana na zgodność z rozkładem chi-kwadrat o p stopniach swobody (gdzie p jest liczbą atrybutów w modelu końcowym). |
Testowanie modelu dla modułu Szeregi czasowe jest funkcjonalnością eksperymentalną.
Zagadnienie testowania modelu szeregu czasowego jest do pewnego stopnia analogiczne do zagadnienia testowania modelu aproksymacyjnego. Test polega na wyliczeniu zagregowanych statystyk mierzących jak dobrze wariancja przewidziana przez model przybliża wariancję zaobserwowaną. Dostępne są następujące miary:
MeanAbsoluteError (MAE) -
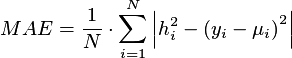
MeanActualValue (MAV) - zaobserwowana średnia całego szeregu:
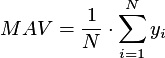
ActualValueVariance (AVV) - zaobserwowana wariancja całego szeregu:
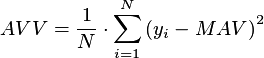
MeanPredictedVariance (MPV) - średnia wartość prognozowanych wariancji:
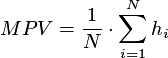
RMSError -
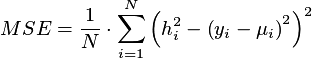
RSquaredError -
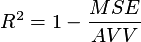
gdzie  jest średnią z zaobserwowanych wartości szeregu,
 oznacza wariancję modelu dla i-tej obserwacji,
 oznacza wartość szeregu dla i-tej obserwacji, a N oznacza liczbę obserwacji w szeregu.
Stosowanie modelu dla modułu Szeregi czasowe jest funkcjonalnością eksperymentalną.
Zastosowanie modeli szeregów czasowych klasy ARCH(p) i GARCH(p,q) sprowadza się do prognozy wartości szeregu w punkcie czasu t+1. W tym momencie możliwe jest prognozowanie tylko na jeden okres czasowy do przodu.
Szczegóły dot. stosowania modelu na zbiorze danych znaleźć można w rozdziale Stosowanie modeli w AdvancedMiner, w sekcji Stosowanie innych modeli data-miningowych.
Po zastosowaniu modelu szeregu czasowego, wynikowa tabela zawiera następujące kolumny:
Tabela 30.4. Szeregi czasowe - Kolumny tabeli wynikowej po zastosowaniu modelu
| Nazwa | Opis | |
| <prefix>_<timepoint> attributes | Oszacowane przez model wartości wariancji dla punktów czasowych t+1, t+2 itd. gdzie t oznacza punkt czasowy dla obecnej obserwacji; "prefix" może być ustawiony przy użyciu metody setPrefix w obiekcie TimeSeriesApplyOutput (domyślnym prefiksem jest "variance"). | |
| regressed_mean |
Zmienna zawierająca wartości liniowego scoringu
 wyliczone z liniowej części modelu GARCH; jeżeli w modelu
nie występuje żaden atrybut objaśniający, zmienna ta sprowadza się
do wartości wyrazu wolnego. | |
| forecast_lowerbound | Dolna granica przedziału ufności dla wariancji prognozowanej w punkcie t+1; przedział ufności jest wyliczany dla współczynnika ufności na poziomie 95%. | |
| forecast_upperbound | Górna granica przedziału ufności dla wariancji prognozowanej w punkcie t+1; przedział ufności jest wyliczany dla współczynnika ufności na poziomie 95%. |