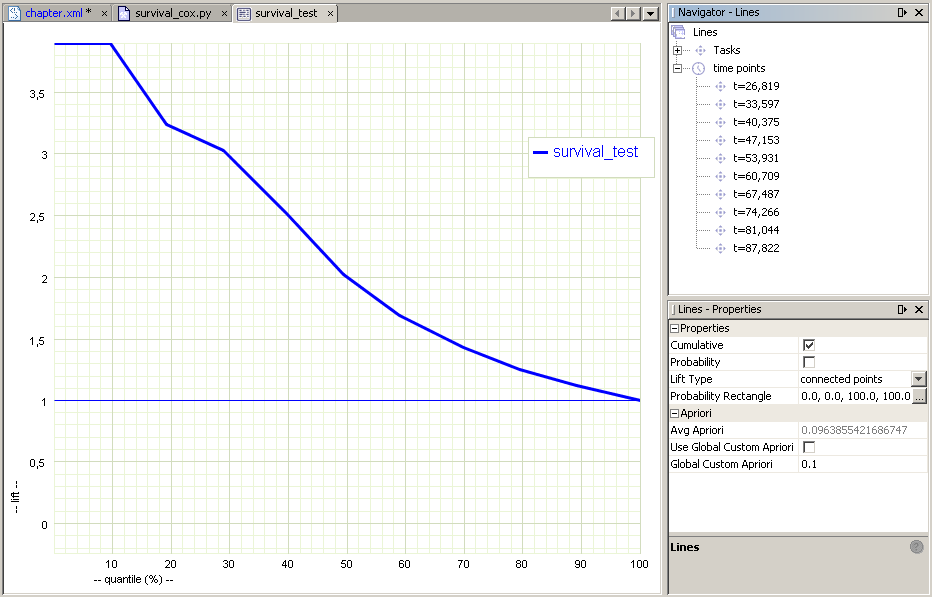
Moduł analizy przeżycia (survival function) może być wykorzystywany do przewidywania rozkładu dalszego czas życia dla osób w danej populacji, w celu zbadania siły wpływu poszczególnych zmiennych na oczekiwany czas dalszego życia i porównania rozkładów czasu dalszego życia dla dwóch różnych podgrup.
Dane które mają być wykorzystane do budowy modelu dalszego czasu życia powinny zawierać kategoryczny dwuwartościowy cenzor i numeryczny target.
Dodatkowo dane do budowy semi-parametrycznego modelu Coxa powinny zawierać numeryczne zmienne ustawione jako aktywne lub obligatoryjne. Aby skorzystać ze zmiennych kategorycznych konieczna jest ich skonwertowanie na binarne zero-jedynkowe zmienne za pomocą binarize procedury z Random Redundant lub włączyć w opcjach Automatic Data Transformation.
Zmienne z brakującymi wartościami (missing) nie są wspierane przez moduł Analizy Przeżycia jeśli nie jest ustawiona opcja Automatic Variable Transformations. Innym sposobem wykorzystania zmiennych z brakującymi wartościami jest wykonanie transformacji ReplaceMissing przed rozpoczęciem budowy modelu.
Budowanie modelu i testy wykonuje się w zwykły sposób, a całą procedurę opisano w rozdziale AdvancedMiner w Praktyce (patrz survival - dalszy czas życia).
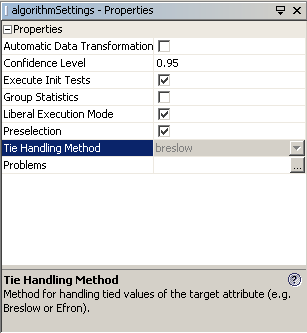
Nie-parametryczny model dalszego czasu życia jest kontrolowany przez następujące ustawienia algorytmu:
Tabela 28.1. Moduł dalszego czasu życia (Survival): Ustawienia Algorytmu
Nie ma zaimplementowanych specjalnych statystyk modelu dla nie-parametrycznych modeli dalszego czasu życia. Estymowane wartości, błędy standardowe, są dostępne w AdvancedMiner Script. Przykładowy skrypt można znaleźć w Dołączone Przykłady. Model nie-parametryczny zawiera także wykresy empirycznych funkcji hazardu i dalszego czasu życia wraz z dolnym i górnym przedziałem ufności dla tych funkcji.
Dla modelu Coxa pełna specyfikacja ustawień modelu zawiera następujące elementy Algorithm Settings: Główne ustawienia (General Algorithm Settings), Optimization Algorithm Settings i Ustawienia Selekcji Zmiennych (Variable Selection Settings) i Ustawienia Dotyczące Transformacji Zmiennych (Transformation Settings).
Cox algorytm jest kontrolowany przez następujące parametry:
Tabela 28.2. Moduł dalszego życia: Ustawienia algorytmu
| Nazwa | Opis | Możliwe wartości | Domyślna wartość |
|---|---|---|---|
| Automatic Data Transformations | jeśli automatyczne transformacje (np. replaceMissing, binaryzacja) powinny być wykonane to TRUE, w przeciwnym wypadku FALSE. | TRUE / FALSE | FALSE |
| Confidence Level | Wartość poziomu ufności do wyliczania przedziałów ufności dla parametrów modelu | wartość rzeczywista z przedziału (0.5,1) | 0.95 |
| Execute Init Tests | jeśli test task ma być wykonany to TRUE, w przeciwnym wypadku FALSE | TRUE / FALSE | TRUE |
| Group Statistics | jeśli statystyki dla grup zmiennych powinny być policzone to TRUE, w przeciwnym wypadku FALSE | TRUE / FALSE | FALSE |
| Liberal Execution Mode | jeśli 'liberalne' wykonanie jest korzystne (nie zatrzymuj się na drobnych błędach) wówczas TRUE, w przeciwnym wypadku FALSE | TRUE / FALSE | TRUE |
| Preselection | Binarny przełącznik, czy mają być liczone statystyki p-value dla jednowymiarowych modeli | TRUE / FALSE | FALSE |
| Tie Handling Method | Która metoda ma być użyta do 'handling tied observations' (obecnie tylko metoda Breslow jest dostępna) | breslow | breslow |
W uzupełnieniu do podstawowych ustawień algorytmu dalszego czasu życia (Survival), użytkownik może korzystać z:
Ustawień Selekcji Zmiennych (Variable Selection Settings) - aby kontrolować zachowanie dostępnych heurystyk do budowy modelu, ustawienia te są opisane w rozdziale Automatyczna Selekcja Zmiennych
Optymalizacji (Optimization Algorithm Settings) - aby kontrolować wybór algorytmu optymalizacji, ustawienia te są opisane w rozdziale Biblioteka Optymalizacji .
Ustawienia Dotyczące Transformacji Zmiennych (Transformation Settings) - aby kontrolować sposób transformacji zmiennych opisany w rozdziale Transformacja.
Notatka
W celu zbudowania modelu Coxa należy wybrać Censor (nazwa cenzorowanej zmiennej mówiącej o ucięciu obserwacji) i Censored Category (wartość zmiennej Censor dla uciętych obserwacji) w ustawieniach (function settings). Więcej szczegółów w rozdziale AdvancedMiner w Praktyce.
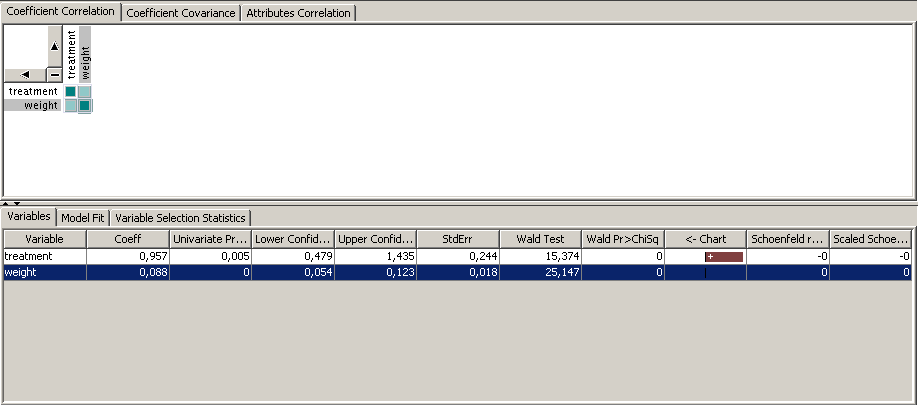
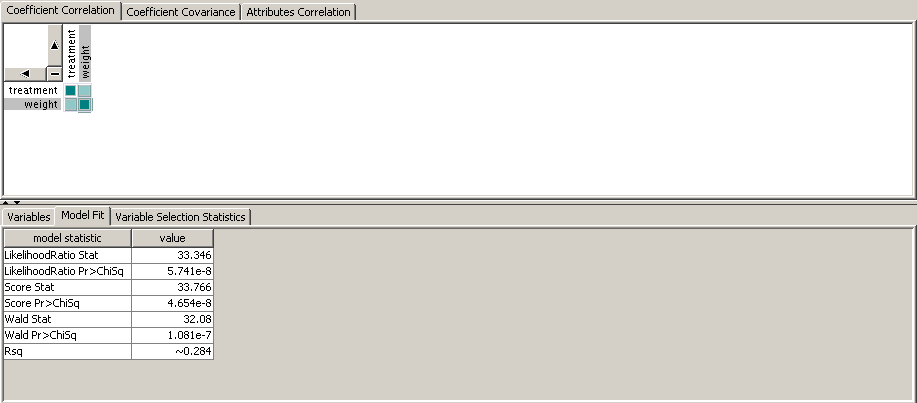
Ostateczny semi-parametryczny model Coxa zawiera statystyki opisujące skuteczność i cechy modelu jako całości (Model Statistics), statystyki opisujące zmienne wchodzące do modelu (Variable Statistics) oraz macierze korelacji i kowariancji.
Tabela 28.3. Statystyki modelu dalszego czasu życia: opisujące zmienne wchodzące do modelu (Variable Statistics)
| Nazwa | Opis |
|---|---|
| Univariate Pr>ChiSq | p-value dla Likelihood Ratio Statystyki policzonej dla jednowymiarowego modelu. Ta statystyka jest liczona tylko jeśli Opcja Preselekcji jest wybrana w bieżących ustawieniach algorytmu |
| Coeff | wartość estymowanego parametru |
| Lower Confidence | dolna granica przedziału ufności dla obecnego estymatora. Przedział ufności jest obliczany dla poziomu ufności określonego w bieżących ustawieniach algorytmu (patrz Confidence Level opcje) |
| Pr(Wald>ChiSq) | p-value dla Statystyki Walda dla estymatora parametru. Statystyka jest testowana z wykorzystaniem rozkładu chi-kwadrat z jednym stopniem swobody |
| Scaled Schoenfeld residual mean | średnia wartość Scaled Shoenfeld Residuals |
| Schoenfeld residual mean | średnia wartość Shoenfeld Residuals |
| StdErr | Błąd standardowy estymatora parametru |
| Upper Confidence | górna granica przedziału ufności dla obecnego estymatora. Przedział ufności jest obliczany dla poziomu ufności określonego w bieżących ustawieniach algorytmu (see the Confidence Level opcje) |
| Variable | nazwa zmiennej |
| Wald Test | Statystyka Walda dla parametru |
- Scaled Shoenfeld Residuals
Scaled Shoenfeld Residuals są obliczane dla każdej obserwacji jako przybliżenie wykorzystując fakt, że macierz wektorów residuów jest dość stabilna w czasie (patrz Grambsch and Therneau 1994):
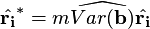
gdzie
 jest wektorem
residuów Shoenfelda dla pojedynczej obserwacji i
 jest liczbą
nieobciętych czasów przeżycia.
- Shoenfeld Residuals
Schoenfeld Residuals są obliczane dla każdej obserwacji jako:
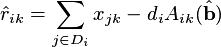
gdzie
 są zdefiniowane w części o
Estymatorze częściowej największej wiarygodności (Partial likelihood function) (szczegóły w Schoenfeld 1982).
- Statystyka Walda
Statystyka Walda jest zdefiniowana jako:
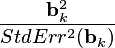
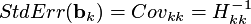
gdzie H jest hesjanem macierzy (macierz drugich pochodnych logarytmu funkcji wiarygodności - log-likelihood function) i U jest gradientem (wektorem pierwszych pochodnych log-likelihood function), oba policzone dla Estymatora Największej Wiarogodności (maximum likelihood estimator MLE).
Tabela 28.4. Statystyki modelu dalszego czasu życia: Statystyki modelu
| Nazwa | Opis |
|---|---|
| Likelihood Ratio Stat | wartość Statystyki współczynnika wiarygodności (Likelihood Ratio Statistic) |
| Pr(LRatio>ChiSq) | p-value dla Statystyki współczynnika wiarygodności (Likelihood Ratio Statistic). Testowana jest zgodność statystyki z rozkładem chi-kwadrat z p stopniami swobody (gdzie p jest liczbą atrybutów wchodzących do ostatecznego modelu). |
| Pr(Score>ChiSq) | p-value dla Score Statistic. Testowana jest zgodność statystyki z rozkładem chi-kwadrat z p stopniami swobody (gdzie p jest liczbą atrybutów wchodzących do ostatecznego modelu). |
| Pr(Wald>ChiSq) | p-value dla Statystyki Walda. Testowana jest zgodność statystyki z rozkładem chi-kwadrat z p stopniami swobody (gdzie p jest liczbą atrybutów wchodzących do ostatecznego modelu). |
| Rsq |  statystyka |
| Score Stat | wartość Score Statistic |
| Wald Stat | wartość statystyki Walda |
- Statystyki współczynnika wiarygodności (Likelihood Ratio Statistic)
Likelihood Ratio Statistic jest obliczany jako:
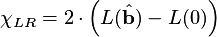

Statystyka
 jest zdefiniowana
jako:
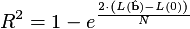
gdzie N jest całkowitą liczbą obserwacji.
- Score statistic
The Score statistic jest zdefiniowana jako:
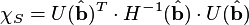
gdzie
 jest gradientem
logarytmu funkcji wiarygodności.
- Statystyka Walda
Statystyka Walda jest zdefiniowana jako:
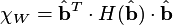
gdzie H jest hesjanem macierzy (macierz drugich pochodnych logarytmu funkcji wiarygodności - log-likelihood function) i U jest gradientem (wektorem pierwszych pochodnych log-likelihood function), oba policzone dla Estymatora Największej Wiarogodności (maximum likelihood estimator MLE).
Tabela 28.5. Statystyki modelu dalszego czasu życia: Kowariancja
| Nazwa | Opis |
|---|---|
| Covariance (Kowariancja) | macierz kowariancji estymatorów parametrów |
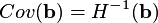
 jest Hessianem
macierzy estymatorów parametrów.
Tabela 28.6. Statystyki modelu dalszego czasu życia: Korelacja
| Nazwa | Opis |
|---|---|
| Correlation (Korelacja) | macierz korelacji estymatorów parametrów |
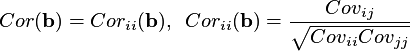
 są
 -tymi elementami
macierzy.
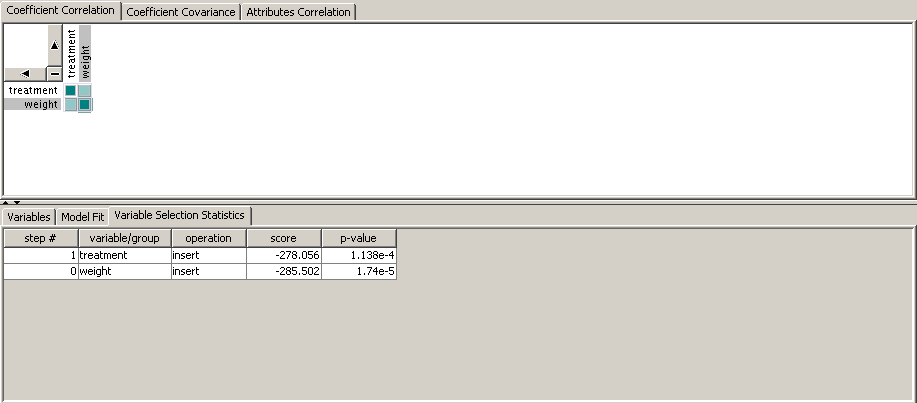
Jeśli została wybrana któraś z automatycznych selekcji zmiennych podczas budowy modelu(np. Variable Selection Method została ustawiona jako forward, backward lub stepwise) wówczas w wyniku ostatecznego modelu będzie pokazana historia kroków selekcji zmiennych. Każdy wpis odpowiada jednej operacji inserted/removed (dodaj/usuń) zmienną i zawiera p-value dla błędu prognozy Likelihood Ratio .
Nie-parametryczny model nie może być zastosowany bez przetestowania.
Aby zastosować model Coxa konieczne jest stworzenie MiningApplyTask z danymi i ustawieniami (zobacz w rozdziale AdvancedMiner w Praktyce). Przypomnijmy, że zbudowanie i przetestowanie modelu Coxa wymaga dodatkowych założeń: Censor i Censored Category:
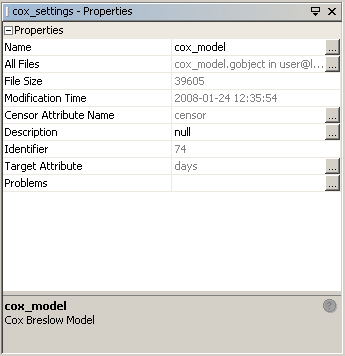
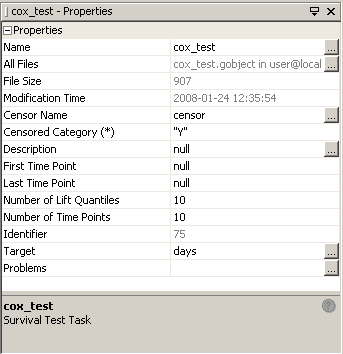
Zastosowanie modelu dalszego czasu życia (survival) odbywa się w prawie ten sam sposób, jaki jest opisany w Zastosowanie Modeli w AdvancedMiner. Główną różnicą jest specyficzny SurvivalApplyOutput, który my wybieramy podczas dodawana applyOutput w MiningApplyTask. Ustawiamy właściwości applyOutput: prefix - jaka jest nazwa prefix używana do tworzenia kolumn wynikowych, first/last time point - które opisują długość przedziałów i ilość prognozowanych punktów w czasie w których policzona zostanie prognoza prawdopodobieństwa dożycia do tych punktów.
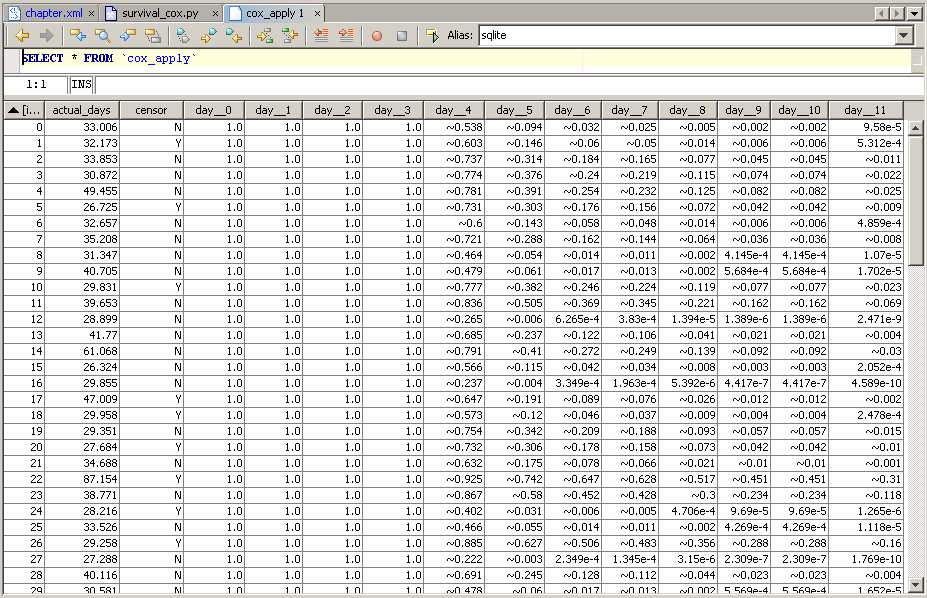
Zastosowując zbudowany model do danych na wyjściu otrzymamy dane, które mogą być przechowywane w zbiorze lub w pliku. Rezultat zawiera prognozowany czas życia oraz użyte dane.
Poniżej przedstawiono przykłady okien wynikowych: