Najważniejszymi wymaganiami odnośnie danych są:
- target musi być zmienną kategoryczną,
- wszystkie zmienne poza targetem muszą być numeryczne.
Przydatne może być standaryzowanie wszystkich zmiennych poza targetem. Dla danych kategorycznych konieczna jest binaryzacja.
Podstawowa procedura budowy modelu do klasteringu jest opisana w rozdziale "AdvancedMiner w praktyce" (por. sekcję Budowa modelu do klasteringu ). Pełna specyfikacja ustawień modelu zawiera elementy Algorithm Settings: General Algorithm Settings , Algorytm uczący and Transformation Settings .
Aby utworzyć model nie tylko do grupowania, ale i klasyfikacji danych, konieczne jest użycie kombinacji klasycznego algorytmu SOM Kohonena z jednym z algorytmów z rodziny LVQ. Początkowo model jest uczony z użyciem algorytmu SOM. Następnie jest uczony z użyciem wybranego algorytmu LVQ. Proces ten przypomina uczenia przyrostowe (ang. incremental training), ale w tym przypadku zmieniane są nie dane treningowe, a sam algorytm. Możliwe jest również wykorzystanie technik klasycznego uczenia przyrostowego dla fazy uczącej SOM i LVQ przez dodanie inputModel w MiningBuildTask .
Algorytmy LVQ były początkowo rozwijane na potrzeby modeli gazu neuronowego. W systemie AdvancedMiner zostały zaadaptowane do map Kohonena. Algorytm SOM daje bardzo dobre rezultaty, dlatego zazwyczaj wystarcza wykonać tylko kilka iteracji algorytmu LVQ.
Tabela 25.1. Sieci Kohonena: ustawienia algorytmu dla algorytmów SOM i LVQ
| Nazwa | Opis | Możliwe wartości | Wartość domyślna |
|---|---|---|---|
| Automatic Data Transformations | TRUE: zostaną wykonane automatyczne transformacje danych (np. replaceMissing, binaryzacja). FALSE: nie zostaną one wykonane. | TRUE / FALSE | FALSE |
| Batch Learning | TRUE: tryb uczenia wsadowego (szybszy ale mniej dokładny). | FALSE, TRUE | FALSE |
| Begin Learning Rate | Początkowa wartość współczynnika uczenia. | Liczby rzeczywiste z przedziału [0,1] | Dla LVQ: 0.1, dla SOM: 0.3 |
| Begin Neighborhood Rate | Początkowy rozmiar sąsiedztwa. | Dodatnie liczby całkowite | Dla LVQ: 0, dla SOM: 2 |
| Cell Type | Kształt komórek (neuronów) w mapie Kohonena. | hexagonal | hexagonal |
| Data Randomization | TRUE: porządek danych uczących w każdej iteracji będzie losowy. | FALSE, TRUE | TRUE |
| Distance Function | Funkcja używana do obliczenia odległości między neuronami a obserwacjami treningowymi. | euclidean, manhattan, minimum, maximum | euclidean |
| End Learning Rate | Końcowa wartość współczynnika uczenia, zwykle mniejsza lub równa beginLearningRate . | Liczby rzeczywiste z przedziału [0,1] | Dla LVQ: 0.01, dla SOM: 0.1 |
| End Neighborhood Rate | Końcowy rozmiar sąsiedztwa, zazwyczaj mniejszy lub równy beginNeighborhoodRate . | Dodatnie liczby całkowite. | 0 |
| Height | Wymiar (liczba neuronów) wertykalny mapy Kohonena. | Dodatnie liczby całkowite. | 10 |
| Number of Iterations | Maksymalna liczba iteracji procesu uczącego. | Dodatnie liczby całkowite | Dla LVQ: 10, dla SOM: 100 |
| Min Error Tolerance | Akceptowany poziom błędu; proces uczący jest zatrzymywany, kiedy błąd dopasowania obniży się poniżej tego poziomu. | Dodatnie liczby rzeczywiste | 0.01 |
| Modification Function | Funkcja używana do modyfikacji współczynnika uczenia dla sąsiedztwa. | standard, uniform, Gaussian, linear, quadratic, reciprocal, quadraticReciprocal | standard |
| Noise Variance | Wariancja szumu dostarczana do danych; kiedy wartość tego współczynnika jest równa lub mniejsza od zera, szum nie jest dodawany do danych. | Nieujemne liczby rzeczywiste | -1.0 |
| Search Type | Algorytm poszukiwania zwycięzcy. | global, random, lastWin | global |
| Seed | Ziarno generatora liczb losowych; kiedy wartość ziarna jest równa 0, generator jest inicjalizowany losową wartością. | Liczby rzeczywiste | 0 |
| Torus | TRUE: mapa Kohonena ma mieć topologię torusa. | FALSE, TRUE | FALSE |
| Validation Error Tolerance | Tolerancja na błąd na danych walidacyjnych; proces uczący zatrzyma się, kiedy wartość aktualnego błędu na danych walidacyjnych będzie większa niż minimum z dotychczasowych błędów przemnożone przez wartość tego współczynnika. | Liczby rzeczywiste większe lub równe 1.0 | 1.0 |
| Validation Window | Liczba dopuszczalnych iteracji dla rosnącego błędu dopasowania na danych walidacyjnych. Kiedy błąd dopasowania na danych walidacyjnych przekroczy tę wartość, proces uczący zatrzyma się. Kiedy wartość tego współczynnika jest równa 0 albo nie podano danych walidacyjnych, ta opcja jest wyłączona. | Dodatnie liczby całkowite. | 10 |
| Width | Wymiar (liczba neuronów) horyzontalny mapy Kohonena. | Dodatnie liczby całkowite | 10 |
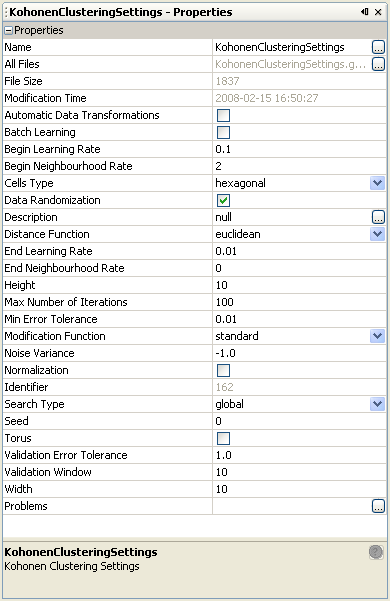
Szczegółowy opis wybranych ustawień:
Opcja Distance Function (funkcja odległości) może przyjmować następujące wartości:
euclidean (euklidejska):
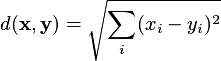
manhattan:
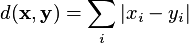
minimum:
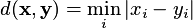
maximum:
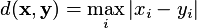
Opcja Modification Function (funkcja modyfikacji współczynnika uczenia) może przyjmować następujące wartości:
standard:
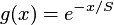
uniform (rozkład jednostajny):

gaussian (gaussowska):
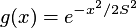
linear (liniowa):
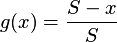
quadratic (kwadratowa):
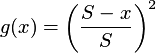
reciprocal (odwrotna):

quadraticReciprocal (odwrotna kwadratowa):
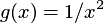
gdzie:
 jest największym dopuszczalnym sąsiedztwem,
a x jest rozmiarem aktualnego sąsiedztwa.
Opcja Search Type (algorytm poszukiwania zwycięzcy) może przyjmować następujące wartości:
global: zwycięzca jest poszukiwany pośród wszystkich neuronów mapy Kohonena,
random: zwycięzca jest poszukiwany lokalnie, począwszy od losowo wybranego neuronu,
lastWin: zwycięzca jest poszukiwany lokalnie, począwszy od neuronu, który wygrał w poprzedniej iteracji.
W uzupełnieniu ustawień specyficznych dla algorytmu Kohonena, użytkownik może użyć Transformation Settings aby kontrolować sposób transformacji danych; te ustawienia są opisane w rozdziale Transformacja.
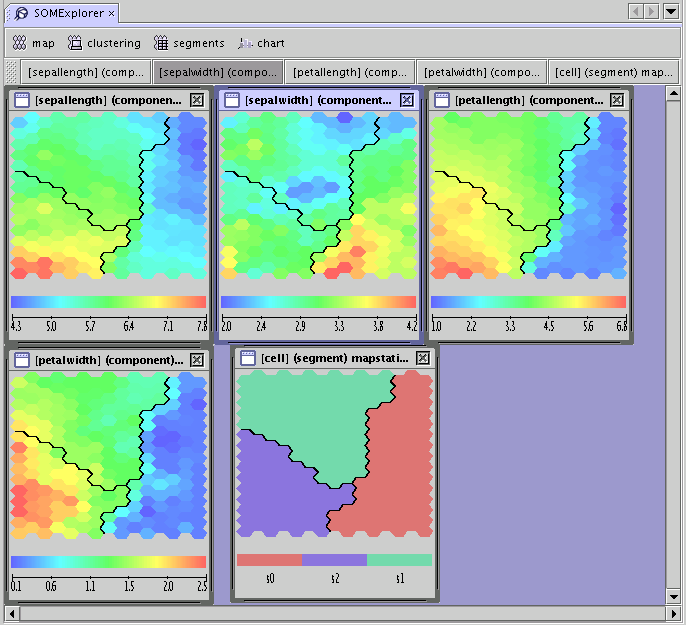
Kiedy zachodzi potrzeba wizualizowania nie tylko wag neuronów (nazywanych komponentami, ang. components) na mapie Kohonena, ale również niektórych statystyk neuronów, konieczne jest uruchomienie tasku ComputeModelStatisticsTask. Do wyliczenia statystyk mogą być użyte dane treningowe albo nowe dane, nawet z większą liczbą atrybutów. Możliwe jest również wyliczenie statystyk bez niektórych atrybutów użytych w procesie uczenia modelu. W tym przypadku uzyskiwane jest przybliżenie wyliczanych statystyk.
Wszystkie zmienne kategoryczne (w tym target) są automatycznie binaryzowane, a statystyki są obliczane dla zmiennych binarnych.