Można założyć, że dane wejściowe są reprezentowane
przez zestaw n-wymiarowych wektorów
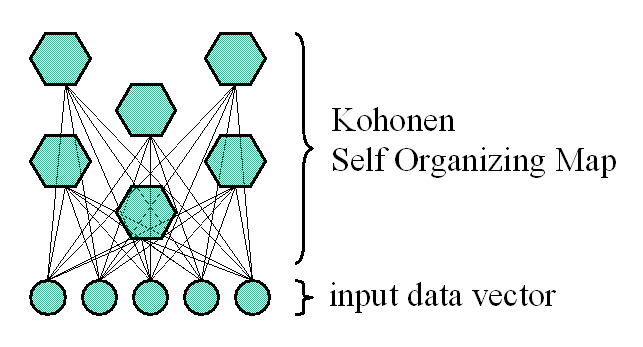
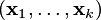 . Wynik jest dwuwymiarową tablicą węzłów wyjściowych.
Ta tablica staje się mapą danych w procesie uczenia.
Każdy węzeł (neuron) jest reprezentowany przez
n-wymiarowy wektor wag.
Dedykowany algorytm uczący został zaproponowany przez Teuvo Kohonena.
Dla każdego wektora uczącego
 :
lokalizowany jest neuron najbliższy wejściowego wektora uczącego. Ten neuron nazywany jest zwycięzcą (
 ):
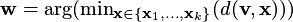
Do zwycięzcy przypisywane są wszystkie neurony
 które pozostają z nim w relacji sąsiedztwa.
Zbiór wszystkich tych neuronów nazywa się
sąsiedztwem.
Wektor wag zwycięzcy jest aktualizowany w następujący sposób:
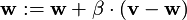
gdzie
 jest współczynnikiem uczenia (ang. learning rate).
Wektory wag sąsiadujące z sąsiedztwem zwycięzcy są uaktualniane zgodnie z formułą:
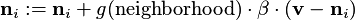
gdzie
 jest funkcją która wylicza modyfikację współczynnika
uczenia dla sąsiedztwa: bliższe sąsiedztwo powinno
uczyć się więcej niż odleglejsze.
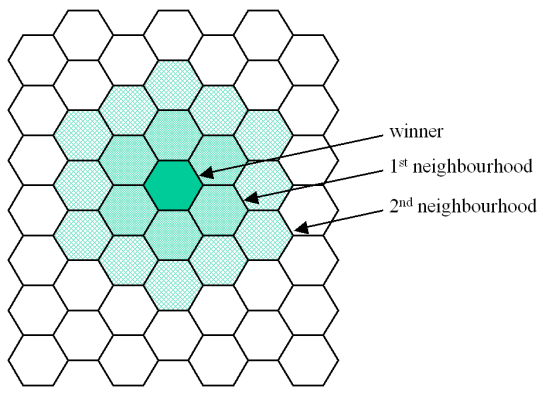
Każdy wektor uczący jest używany raz w każdej iteracji. W kolejnych iteracjach używane sąsiedztwo powinno się kurczyć, a współczynnik uczenia zmniejszać.
W systemie AdvancedMiner zaimplementowano trzy algorytmy LVQ: LVQ, LVQ21 i LVQ3:
-
Algorytm LVQ jest bardzo podobny do klasycznego
algorytmu uczącego SOM. Odmienna jest reguła
aktualizacji wag zwycięzcy:
jeżeli zwycięzca (
 ) i wektor uczący (
 ) mają przypisaną taką samą decyzję,
wówczas używamy do aktualizacji wag
takiej formuły, jak w algorytmie SOM:
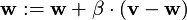
w przeciwnym przypadku:
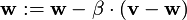
-
Algorytm LVQ21 używa takiej samej reguły aktualizacji
wag zwycięzcy co algorytm LVQ, ale w tym przypadku
jest dwóch zwycięzców (zwycięzca
 i vice-zwycięzca
 ). Wagi dla obu z nich są aktualizowane tylko
wtedy, gdy spełnione są dwa następujące warunki:
(1) dokładnie jeden z nich ma tę samą decyzję
co wektor uczący
 i (2) obserwacja treningowa trafia do specjalnego
okna między zwycięzcami (sytuacja B):
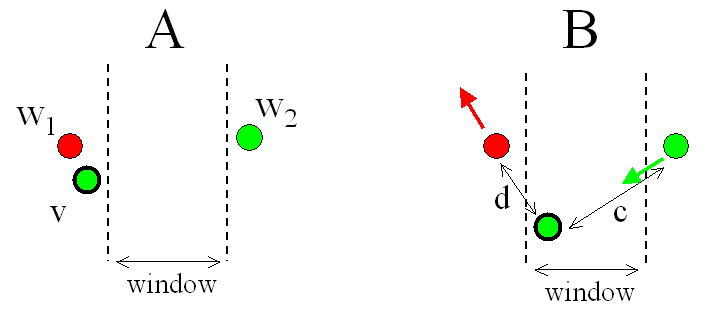
Algorytm LVQ3 różni się od LVQ21 tylko w jeden sposób: wagi dla obu zwycięzców są aktualizowane tylko wówczas, gdy przynajmniej jeden z nich ma tę samą decyzję, co wektor uczący.