W tym podrozdziale opisane są funkcje dostępne w GDBase.
Funkcje proste mogą być użyte w dowolnym wyrażeniu. Ich wynik zwracany jest natychmiast.
-
charindex(X, Y [,Z])
Zwraca pozycję pierwszego wystąpienia literału Y w literale X, począwszy od pozycji Z (domyślnie 1). Pozycje są liczone od 1. W przypadku, gdy Y nie zostanie znalezione, zwracana jest wartość 0.
-
difference(X, Y)
Zwraca liczbę różnych znaków pomiędzy wartościami soundex obu argumentów.
-
glob(X, Y)
Działanie tej funkcje jest takie samo, jak operatora GLOB.
-
leftstr(X, Y)
Zwraca Y znaków literału X od lewej strony. Jeśli Y jest większe niż długość X, zwraca kopię X.
-
length(X)
Zwraca liczbę znaków w literał X.
-
levenshtein(X, Y, [Z])
Zwraca odległość Levenshtein-a pomiędzy literałami X i Y. Jeśli trzeci parametr nie jest Null, zwrócona zostanie odległość znormalizowana.
-
levenshtein_damerau(X, Y, [Z])
Zwraca odległość Levenshtein-a - Demerau- pomiędzy literałami X i Y. Jeśli trzeci parametr nie jest Null, zwrócona zostanie odległość znormalizowana.
-
like(X, Y [,Z])
Działanie tej funkcji jest równoważne z wykonaniem operacji Y LIKE X [ESCAPE Z] .
-
lower(X)
Zwraca kopię literału X, w której wszystkie litery ASCII zostały zamienione na swoje małe odpowiedniki.
-
ltrim(X)
Usuwa białe znaki z początku literału X.
-
padc(X, Y[ ,Z])
Dodaje znaki Z (domyślnie spacje) na końcu i początku literału X tak, aby otrzymać literał długości Y i zwraca tak otrzymany literał. Liczby dodanych znaków na początku i na końcu różnią się co najwyżej o 1. Jeśli Y jest większe niż długość X, zwraca X. Dodatkowo, padc(NULL) zwraca NULL.
-
padl(X, Y[, Z])
Dodaje znaki Z (domyślnie spacje) na początku literału X tak, aby otrzymać literał długości Y i zwraca tak otrzymany literał. Jeśli Y jest większe niż długość X, zwraca X. Dodatkowo, padl(NULL) zwraca NULL.
-
padr(X, Y[ ,Z])
Dodaje znaki Z (domyślnie spacje) na końcu literału X tak, aby otrzymać literał długości Y i zwraca tak otrzymany literał. Jeśli Y jest większe niż długość X, zwraca X. Dodatkowo, padr(NULL) zwraca NULL.
-
proper(X)
Zwraca kopię literału X, w której pierwszy znak, jeśli jest literą, został zamieniony na jej wielki odpowiednik.
-
qgram(X, Y[, normalize[, q]])
Funkcja oblicza odległość q-gram-ową od literału X do literału Y. Jeśli argument normalize jest pominięty lub ma wartość Null, obliczana jest odległość nieznormalizowana. W przeciwnym przypadku zwracana jest odległość znormalizowana, która jest liczbą pomiędzy 0 i 1. Opcjonalny parametr q określa długość q-gramów.
-
quote(X)
Zwraca kopię literału X zmodyfikowaną tak, że nadaje się ona do włączenia jako literał do instrukcji SQL.
-
regexp(regular-expression, text)
Za pomocą tej funkcji można przeszukiwać tekst za pomocą wyrażeń regularnych. Funkcja zwraca 1 jeśli w literał text znaleziono sekwencję znaków zgodną z podanym wyrażeniem regularnym regular-expression. W przeciwnym razie funkcja zwraca 0. Zob. także opis operatora REGEXP .
Sztuka tworzenia wyrażeń regularnych to bardzo szeroki temat. Więcej informacji o wyrażeniach regularnych można znaleźć na stronie PCRE website.
-
regexp_group(regular-expression, text, group-num)
Zwraca jedną z grup zdefiniowanych przez wyrażenie regularne regular-expression znalezionych w literale text. Argument group-name określa numer grupy, licząc od lewej, wg wystąpień lewego separatora grup '('. Jeżeli group-name ma wartość 0 zwracany jest cały tekst dopasowany do wyrażenia regularnego.
Przykład 33.25. Wyszukiwanie numerów telefonicznych
table 'TAB1':
    id  number
    1   'phone 500111222'
    2   '+48500333444'
    3   '600112233'
    4   '0501555666'

# this command extracts the last 6 digits from phone numbers if they are preceeded
# by 500 or 501. Note that any digits precceding 500 or 501 are not taken into account.
sql TAB2:
    SELECT *, REGEXP_GROUP('.*((500)|(501))(\d{6}).*', number, 4) AS extr FROM TAB1
print TAB2

# this command extracts complete 9-digit phone numbers starting with 500 or 501
sql TAB3:
    SELECT *, REGEXP_GROUP('.*((((500)|(501))(\d{6}))).*', number, 1) AS extr FROM TAB1
print TAB3
Output:
id | number | extr | +--+-----------------+--------+-- 1 | phone 500111222 | 111222 | 2 | +48500333444 | 333444 | 3 | 600112233 | None | 4 | 0501555666 | 555666 | id | number | extr | +--+-----------------+-----------+-- 1 | phone 500111222 | 500111222 | 2 | +48500333444 | 500333444 | 3 | 600112233 | None | 4 | 0501555666 | 501555666 |-
regexp_replace(X, Y, Z)
Funkcja działa podobnie jak replace(X, Y, Z), z tą różnicą, że Y jest wyrażeniem regularnym.
Przykład 33.26. Usuwanie znaków nie będących cyframi z numerów telefonicznych
table 'TAB1':
    id  number
    1   '500123456'
    2   '500-123-123'
    3   '0500123789'
    4   '600111222'
    5   'tel: 600123321'
    6   '+48500111222'
    7   '0226942500'
    8   '226531010 (work)'
    9   '(0-22)6208518'

#remove all non-digits from the number field
sql TAB2:
    SELECT *, REGEXP_REPLACE(number, '\D', '') AS digits_only FROM TAB1
print TAB2
Output:
id | number | digits_only | +--+------------------+-------------+-- 1 | 500123456 | 500123456 | 2 | 500-123-123 | 500123123 | 3 | 0500123789 | 0500123789 | 4 | 600111222 | 600111222 | 5 | tel: 600123321 | 600123321 | 6 | +48500111222 | 48500111222 | 7 | 0226942500 | 0226942500 | 8 | 226531010 (work) | 226531010 | 9 | (0-22)6208518 | 0226208518 |-
replace(X, Y, Z)
Zamienia wszystkie wystąpienia literału Y w X na Z i zwraca tak otrzymany literał.
-
replace_chars(X, Y, Z)
Zwraca kopię literału Z, w której każdy znak z literału Y został zastąpiony odpowiadającym mu znakiem z literału Z.
-
replicate(X, Y)
Zwraca literał łańcuchowy składający się z Y kolejno po sobie następujących kopii literału X.
-
reverse(X)
Odwraca kolejność znaków w literale X i zwraca wynik.
-
rightstr(X, Y)
Zwraca Y znaków literału X od prawej strony. Jeśli Y jest większe niż długość X, zwraca kopię X.
-
rtrim(X)
Usuwa białe znaki z końca literału X.
-
strfilter(X, Y)
Zwraca kopię literału X, z której usunięto wszystkie znaki, które nie występują w literale Y.
-
substr(X, Y, Z)
Zwraca fragment literału X długości Z, składający się ze znaków od pozycji Y. Jeśli Y jest liczbą ujemną, pozycje znaków są liczone od końca literału X.
-
trim(X)
Zwraca kopię literału X, z usuniętymi z początki i końca białymi znakami.
-
upper(X)
Zwraca kopię literału X, w której wszystkie litery ASCII zamieniono na ich wielkie odpowiedniki.
-
words_count(X[, Y])
Dzieli łańcuch X na podłańcuchy, używając Y jako separatora, i zwraca liczbę tak otrzymanych podłańcuchów.
-
words_intersect(X, Y[, Z])
Dzieli oba literały X i Y na podliterały za pomocą separatora Z i zwraca liczbę podliterałów, które występują zarówno w X jak i Y.
Separator Z jest definiowany jako wyrażenie regularne i domyślnie ma wartość '\s+'.
-
words_sort(X[, Y[, Z]])
Dzieli literał X na podliterały za pomocą Y jako separatora, sortuje otrzymane podliterały i zwraca literał otrzymany poprzez ich konkatenacje w posortowanej kolejności, stosując literał Z do oddzielania kolejnych pozycji.
Separator Y jest definiowany jako wyrażenie regularne i domyślnie ma wartość '\s+'. Domyślną wartością Z jest pusty literał.
-
abs(X)
Zwraca wartość bezwzględną X.
-
acos(X)
Zwraca arkus kosinus liczby X (w przedziale [0, π]).
-
acosh(X)
Zwraca area kosinus hiperboliczny liczby X (w przedziale [0, ∞]).
-
asin(X)
Zwraca arkus sinus liczby X (w przedziale [-π/2, +π/2]).
-
asinh(X)
Zwraca area sinus hiperboliczny liczby X.
-
atan(X)
Zwraca arkus tangens liczby X (w przedziale (-π/2, +π/2)).
-
atanh(X)
Zwraca area tangens hiperboliczny liczby X.
-
atan2(Y, X)
oratn2(Y, X)
Zwraca kąt (w radianach z przedziału [-π, +π]), którego tangens wynosi Y/X.
-
ceil(X)
Zwraca najmniejszą liczbę całkowitą nie większą niż X.
-
cos(X)
Zwraca kosinus liczby X. Jeśli liczba X jest zbyt duża wynik może być niedokładny, jednak żaden błąd nie zostanie zgłoszony.
-
cosh(X)
Zwraca kosinus hiperboliczny liczby X.
-
cot(X)
Zwraca kotangens liczby X. Jeśli liczba X jest zbyt duża wynik może być niedokłądny, jednak żaden błąd nie zostanie zgłoszony.
-
coth(X)
Zwraca kotangens hiperboliczny liczby X.
-
degrees(X)
Zwraca stopnie odpowiadające X radianom.
-
exp(X)
Zwraca eksponentę liczby X.
-
floor(X)
Zwraca największą liczbę całkowitą mniejszą lub równą niż liczba X.
-
log(X)
Zwraca logarytm naturalny liczby X; Jeśli X <= 0 zwraca NULL.
-
log10(X)
Zwraca logarytm dziesiętny liczby X; Jeśli X <= 0 zwraca NULL.
-
pi()
Zwraca (przybliżoną) wartość liczby Pi (π).
-
power(X, Y)
Zwraca X podniesione do potęgi Y.
-
probit(X)
Oblicza funkcję probit dla argumentu X.
-
radians(X)
Zwraca stopnie odpowiadające X radianom.
-
rand([X])
Zwraca zmiennoprzecinkową liczbę pseudolosową z przedziału [0, 1). X jest opcjonalnym parametrem określającym liczbę inicjującą (seed) generator.
-
random([X])
Zwraca pseudolosową liczbę całkowitą pomiędzy -9223372036854775808 i +9223372036854775807. X jest opcjonalnym parametrem określającym liczbę inicjującą (seed) generator.
-
round(X[, Y])
Zaokrągla liczbę X do Y cyfr po przecinku. Domyślnie Y przyjmuje wartość 0.
-
sign(X)
Zwraca +1,0 lub -1 w zależności od tego, czy X jest dodatnie, zero lub ujemne. Jeśli X jest NULL zwraca NULL.
-
sin(X)
Zwraca sinus liczby X. Jeśli liczba X jest zbyt duża wynik może być niedokładny, jednak żaden błąd nie zostanie zgłoszony.
-
sinh(X)
Zwraca sinus hiperboliczny liczby X.
-
square(X)
Zwraca kwadrat liczby X.
-
sqrt(X)
Zwraca pierwiastek kwadratowy liczby X. Jeśli X < 0 zwraca NULL.
-
tan(X)
Zwraca tangens liczby X. Jeśli liczba X jest zbyt duża wynik może być niedokładny, jednak żaden błąd nie zostanie zgłoszony.
-
tanh(X)
Zwraca tangens hiperboliczny liczby X.
Funkcje opisane w tym rozdziale wykonują operacje na wartościach typu DATE, TIME and DATETIME, które są odpowiednio sformatowanymi literałami łańcuchowymi (zob. Zapisywanie dat i czasów w literałach łańcuchowych).
Za pomocą tych funkcji można uzyskać informacje przechowywane w obiektach DATE, TIME i DATETIME. Jako parametry tych funkcji, po argumencie timestring można podać jeden lub kilka modyfikatorów, (również w postaci literałów łańcuchowych), za pomocą których można manipulować literałem reprezentującym datę/czas.
W tej grupie najbardziej ogólny charakter ma funkcja strftime().
-
date(timestring, modifier, modifier, ...)
Zwraca datę w formacie 'YYYY-MM-DD'.
-
datetime(timestring, modifier, modifier, ...)
Zwraca datę i czas w formacie 'YYYY-MM-DD HH:MM:SS'.
-
day(timestring, modifier, modifier, ...)
Zwraca liczbę całkowitą (0-31) oznaczającą dzień miesiąca.
-
hour(timestring, modifier, modifier, ...)
Zwraca liczbę całkowitą (0-23) oznaczającą godzinę.
-
julianday(timestring, modifier, modifier, ...)
Zwraca liczbę zmiennoprzecinkową reprezentującą datę w formacie Juliańskim, czyli równą liczbie dni od południa w Greenwich 24 listopada 4714 r. p.n.e.
-
minute(timestring, modifier, modifier, ...)
Zwraca liczbę całkowitą (0-59) oznaczającą minuty.
-
month(timestring, modifier, modifier, ...)
Zwraca liczbę całkowitą (0-12) oznaczającą miesiąc.
-
second(timestring, modifier, modifier, ...)
Zwraca liczbę całkowitą (0-59) oznaczającą sekundy.
-
strftime(format, timestring, modifier, modifier, ...)
Zwraca wartość typu TEXT zawierającą datę sformatowaną zgodnie ze specyfikacją podaną w pierwszym argumencie format jako literał łańcuchowy.
Argument format może zawierać następujące symbole specjalne:
Tabela 33.3. Symbole specjalne określające format dla funkcji strftime
Symbol Opis Formatowanie %d
dzień miesiąca 'DD' %f
sekundy, łącznie z częścią ułamkową 'SS.SSS' %H
godzina 'HH' %j
dzień roku (001-366) 'NNN' %m
miesiąc 'MM' %M
minuta 'MM' %s
liczba sekund, która upłynęła od 1970-01-01 %S
liczba sekund 'SS' %w
dzień tygodnia (0-6), '0' odpowiada niedzieli. 'N' %W
tydzień od początku roku (00-59), pierwszy tydzień to '00' 'NN' %Y
rok (0000-9999) 'YYYY' -
strptime(format, string)
Ta funkcja zwraca obiekt DATETIME odczytany z literał łańcuchowego string zgodnie ze specyfikacją podaną w literale format. Zasady odczyt formatowania są następujące:
Tabela 33.4. Symbole określające formatowanie dla funkcji strptime
Symbol Opis Przykłady y
rok yyyy -> 1996, yy > 96
M
miesiąc MM > 01
d
dzień dd -> 01, dd > 23
H
godzina HH -> 03, HH > 21
m
minuty mm -> 07, mm > 58
s
sekundy ss -> 08 ss > 56
S
milisekundy SSS -> 023
Dodatkowo, argument format może zawierać inne znaki, takie jak - . / .
Jeżeli nie da się odczytać daty/czasu zgodnie z podanym formatowaniem zwracane jest wartość NULL.
Notatka
Zwracana jest zawsze obiekt typu DATETIME, nawet jeśli odczytane informacje dotyczą tylko daty lub tylko czasu.-
time(timestring, modifier, modifier, ...)
Zwraca czas w formacie HH:mm:ss.
-
year(timestring, modifier, modifier,...)
Zwraca rok.
Za pomocą modyfikatorów można zmienić interpretację podanego znacznika czasu. Modyfikatory są stosowane od lewej do prawej.
Tabela 33.5. Modyfikatory znaczników czasu
| Modyfikator | Opis |
|---|---|
NNN cmonths | zmienia znacznik czasu o NNN miesięcy; działanie jest nieco inne od months, zob. poniższą uwagę. |
NNN cyears | zmienia znacznik czasu o NNN lat; działanie jest nieco inne od years, zob. poniższą uwagę. |
NNN days | zmienia znacznik czasu o NNN dni |
NNN hours | zmienia znacznik czasu o NNN godzin |
NNN minutes | zmienia znacznik czasu o NNN minut |
NNN months | zmienia znacznik czasu o NNN miesięcy; działanie jest nieco inne od cmonths, zob. poniższą uwagę. |
NNN years | zmienia znacznik czasu o NNN lat; działanie jest nieco inne od cyears, zob. poniższą uwagę. |
end of day | przesuwa znacznik czasu do końca doby, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-MM-dd 23:59:59.999. |
end of hour | przesuwa znacznik czasu do końca godziny, czyli zmienia YYY-MM-dd HH:mm:ss.SSS na yyyy-MM-dd HH:59:59.999 |
end of minute | przesuwa znacznik czasu do końca minuty, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-MM-dd HH:mm:59.999 |
end of month | przesuwa znacznik czasu do końca miesiąca, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-MM-dd 23:59:59.999, gdzie dd to ostatni dzień miesiąca MM. |
end of second | przesuwa znacznik czasu do końca sekundy, czyl zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-MM-dd HH:mm:ss.999 |
end of year | przesuwa znacznik czasu do końca roku, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-12-31 23:59:59.999. |
first day | cofa znacznik czasu do pierwszego dnia miesiąca, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-MM-01 HH:mm:ss.SSS |
first hour | cofa znacznik czasu do pierwszej godziny dnia, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-MM-dd 00:mm:ss.SSS. |
first minute | cofa znacznik czasu do pierwszej minuty godziny, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-MM-dd HH:00:ss.SSS. |
first month | cofa znacznik czasu do pierwszego dnia miesiąca, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-01-dd HH:mm:ss.SSS. |
first second | cofa znacznik czasu do pierwszej sekundy minuty, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-MM-dd HH:mm:00.SSS. |
last day | przesuwa znacznik czasu do ostatniego dnia miesiąca, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-MM-dd HH:mm:ss.SSS, gdzie dd oznacza ostatni dzień danego miesiąca. |
last hour | przesuwa znacznik czasu do ostatniej godziny dnia, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-MM-dd 23:mm:ss.SSS. |
last minute | przesuwa znacznik czasu do ostatniej minuty godziny, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS to yyyy-MM-dd HH:59:ss.SSS. |
last month | przesuwa znacznik czasu do ostatniego miesiąca roku, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-12-dd HH:mm:ss.SSS. |
last second | przesuwa znacznik czasu do ostatniej sekundy minuty, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-MM-dd HH:mm:59.SSS. |
localtime | zmienia znacznik czasu na czas lokalny, przy założeniu, że znacznik czasu przechowuje czas UTC. |
start of day | cofa znacznik czasu do początku doby, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-MM-dd 00:00:00.000. |
start of hour | cofa znacznik czasu do początu godziny, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-MM-dd HH:00:00.000. |
start of minute | cofa znacznik czasu do początku miuty, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-MM-dd HH:mm:00.000. |
start of month | cofa znacznik czasu do początku miesiącu, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-MM-01 00:00:00.000. |
start of second | cofa znacznik czasu do początku sekundy, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-MM-dd HH:mm:ss.000. |
start of year | cofa znacznik czasu do początku roku, czyli zmienia yyyy-MM-dd HH:mm:ss.SSS na yyyy-01-01 00:00:00.000. |
unixepoch | jeżeli poprzedzający timestring jest w formacie 'DDDDDDDDDD', zwraca znacznik czasu otrzymany przez dodanie podanej liczby sekund do znacznika 1970-01-01 00:00:00.000. |
utc | konwertuje znacznik czasu na UTC, przy założeniu, że znacznik używa czasu lokalnego. |
weekday N | przesuwa znacznik czasu do następnego N-tego dnia tygodnia, 0 to niedziel, 1 to poniedziałek, itd. |
Notatka
Modyfikator months zmienia znacznik czasu o różnicę w dniach pomiędzy datą wyjściową i ostatnim dniem nowego miesiąca.
Modyfikator cmonths zastępuje wyjściowy dzień miesiąca ostatnim dniem nowego miesiąca.
Różnice występują w przypadku, gdy dzień miesiąca w dacie wejściowej nie występuje w dacie przesuniętej. Zob. poniższe przykłady.
SELECT date('2001-01-31', '+1 cmonths')
zwraca 2001-02-28, podczas gdy
SELECT date('2001-01-31', '+1 months')
zwraca 2001-03-03. Podobnie
SELECT date('2001-03-31', '-1 cmonths')
zwraca 2001-02-28, podczas gdy
SELECT date('2001-03-31', '-1 months')
zwraca 2001-03-03.
Modyfikatory years i cyears różnią się w działaniu tylko w sytuacji, gdy modyfikowana data to 29 luty (w roku przestępnym), a rok otrzymany w wyniku modyfikacji nie jest przestępny. Modyfikator years zamieni datę na 1 marca, a cyears na 28 lutego.
Notatka
Cyfry NNN poprzedzające modyfikatory cmonths, cyears, days, hours, minutes, months, years mogą być poprzedzone znakiem, ponadto NNN może być zastąpione liczbą całkowitą, co ilustruje przykład.
Modyfikatory cmonths, days, hours można także stosować bez końcowej litery 's', czyli cmonth, day, hour, itp.
Przykład 33.28. Wyznaczanie ostatniego dnia bieżącego miesiąca.
SELECT date('now','start of month','+1month','-1 day');
Przykład 33.29. Wyznaczanie daty i czasu na podstawie uniksowego znacznika czasu 1092941466.
SELECT datetime(1092941466, 'unixepoch');
Przykład 33.30. Wyznaczenie daty i czasu na podstawie uniksowego znacznika czasu 1092941466 z uwzględnieniem lokalnej strefy czasowej.
SELECT datetime(1092941466, 'unixepoch','localtime');
Przykład 33.32. Wyznaczenie liczby dni, które upłynęły od bitwy pod Grunwaldem.
SELECT julianday('now') - julianday('1410-07-15');
Przykład 33.33. Obliczenie liczby sekund od teraz do innego znacznika czasu.
SELECT julianday('now')*86400 - julianday('2004-01-01 02:34:56')*86400;
Za pomocą poniższych funkcji można obliczyć odstęp między dwoma znacznikami czasu. Wymagają one dwóch argumentów typu DATE, TIME, lub DATETIME, albo odpowiednio sformatowanych literałów łańcuchowych.
-
datediff(date1, date2)
Zwraca różnicę pomiędzy dwiema datami w dniach; działa z typami DATE, DATETIME.
-
daydiff(date1, date2)
Funkcja działa tak samo jak datediff(date1, date2)
-
monthdiff(date1, date2)
Zwraca odstęp między dwoma datami w miesiącach, bez uwzględniania dni miesiąca.
-
yeardiff(date1, date2)
Zwraca odstęp między dwoma datami w latach, bez uwzględniania miesięcy w roku i dni miesiący.
-
timediff(time1, time2)
Zwraca odstęp między dwoma znacznikami czasu w godzinach i sekundach, działa tylko z typem TIME.
Literał łańcuchowy reprezentujący znacznik czasu może mieć jeden z następujących formatów:
yyyy-MM-dd
yyyy-MM-dd HH:mm
yyyy-MM-dd HH:mm:ss
yyyy-MM-dd HH:mm:ss.SSS
yyyy-MM-ddTHH:mm
yyyy-MM-ddTHH:mm:ss
yyyy-MM-ddTHH:mm:ss.SSS
HH:mm
HH:mm:ss
HH:mm:ss.SSS
now
NNNN.NNNN
W wariantach od 5 do 7, "T" oznacza symbol oddzielający datę od czasu, zgodnie z wymogami standardu ISO-8601. Warianty od 8 do 10 określają tylko czas, przy założeniu, że data to 2000-01-01. W wariancie 11 literał 'now' jest zamieniany na bieżącą datę i czas UTC. Wariant 12 to dzień juliański reprezentowany jako liczba zmiennoprzecinkowa.
-
coalesce(X, Y, ...)
Zwraca pierwszy argument od lewej, który nie jest NULL, jeżeli takiego argumentu nie ma, zwraca NULL. Wymaga minimum 2 argumentów.
-
ifnull(X, Y)
Działa tak samo, jak coalesce(X, Y).
-
last_insert_rowid()
Zwraca ROWID ostatnio wstawionego wiersza w ramach bieżącego połączenia z bazą danych.
-
nullif(X, Y)
Zwraca pierwszy argument, jeżeli oba argumenty są różne, w przeciwnym przypadku zwraca NULL.
-
if(X, Y [,Z])
Jeśli X ma wartość True, zwraca Y (w przeciwnym przypadku Z).
-
gdbase_version()
Zwraca oznaczenie wersji bazy danych GDBase.
Funkcje agregujące mogą występować tylko w instrukcjach SELECT. Jeżeli nie występuje klauzula GROUP BY, funkcje te obliczają wyniki dla wszystkich wierszy wynikowych. Jeżeli klauzula GROUP BY występuje, wyniki są obliczane oddzielnie dla każdej grupy.
Jeżeli funkcja agregujące przyjmuje pojedynczy argument, może on być poprzedzony słowem kluczowym DISTINCT. Wówczas duplikaty elementów zostaną odrzucone i nie wpłyną na wynik obliczony przez funkcję. Na przykład, funkcja count(DISTINCT X) zwróci liczbę różnych wartości w kolumnie X, zamiast wszystkich wartości, które nie są Null.
-
avg(X)
Zwraca średnią wszystkich wartości w kolumnie X, które nie są Null. Literały łańcuchowe, których nie da się odczytać jako liczb są wliczane z wartością 0. Wynik jest zawsze typu FLOAT.
-
count([X])
Bez argumentu zwraca liczbę wierszy, z argumentem zwraca liczbę wartości różnych od Null w kolumnie X.
-
group_concat(X[, Y[, Z]])
Zwraca literał łańcuchowy otrzymane przez konkatenację wszystkich różnych od Null wartości w kolumnie X, odseparowanych literałem Y (domyślnie jest to przecinek). Parametr Z określa maksymalny rozmiar bufora dla danych tekstowych. Jeśli w tekście występują wyłącznie znaki ASCII, domyślny rozmiar bufora jest równy długości tekstu, w innym przypadku domyślny rozmiar bufora wynosi 10 000. Jeżeli Z <=0, rozmiar bufora będzie ograniczony jedynie przez ilość dostępnej pamięci.
-
group_min(X, Y)
Zwraca wartość pierwszego argumentu odpowiadającą najmniejszej wartości drugiego argumentu. Zob. przykład użycia funkcji group_max.
-
group_max(X, Y)
Zwraca wartość pierwszego argumentu odpowiadającą największej wartości drugiego argumentu. Poniższy przykład pokazuje wykorzystanie funkcji group_max w instrukcji SELECT.
Przykład 33.37. Wyszukiwanie ostatnich transakcji za pomocą group_max
table 'TAB1':
    customer  day  transaction_id
    1         1    124345324
    2         1    3252352
    3         5    325235
    3         2    4325435
    3         3    3333333
    3         1    111111111
    4         4    4333333
    4         5    3435555
    4         1    9999999

sql TAB2:
    SELECT customer, group_max(transaction_id, day) FROM TAB1 GROUP BY customer

print TAB2
Wynik:
customer | group_max(transaction_id, day) | +--------+--------------------------------+-- 1 | 124345324 | 2 | 3252352 | 3 | 325235 | 4 | 3435555 |-
lower_quartile(X[, W])
Zwraca dolny (ważony) kwartyl kolumny X. W jest opcjonalnym argumentem określającym zmienną z wagami - domyślnie waga jest stała.
-
max(X)
Zwraca maksymalną wartość w kolumnie X. Jeżeli wszystkie wartości są Null, zwraca Null.
-
median(X[, W])
Zwraca (ważoną) medianę kolumny X. W jest opcjonalnym argumentem określającym zmienną z wagami - domyślnie waga jest stała.
-
min(X)
Zwraca minimalną wartość w kolumnie X. Jeżeli wszystkie wartości są Null, zwraca Null.
-
mode(X[, W])
Zwraca najczęstszą (z uwzględnieniem wag) wartość w kolumnie X. W jest opcjonalnym argumentem określającym zmienną z wagami - domyślnie waga jest stała.
-
quantile(X, N[, W])
Zwraca N-ty (ważony) kwantyl dla zmiennej X. Drugi argument musi być liczbą z przedziału [0, 100]. W jest opcjonalnym argumentem określającym zmienną z wagami - domyślnie waga jest stała.
-
stdev(X)
Zwraca odchylenie warunkowe kolumny X.
-
upper_quartile(X[, W])
Zwraca górny (ważony) kwartyl kolumny X. W jest opcjonalnym argumentem określającym zmienną z wagami - domyślnie waga jest stała.
-
variance(X)
Zwraca wariancję kolumny X.
-
sum(X), total(X)
Te dwie funkcje zwracają sumę wszystkich różnych od Null wartości w kolumnie X. Jeżeli wszystkie wartości są Null, funkcja sum(X) zwróci Null, natomiast funkcja total(X) zwróci 0.0.
Funkcja total(X) zawsze zwraca wynik typu FLOAT, natomiast sum(X) zwróci wynik typu INTEGER, o ile wszystkie agregowane wartości też są tego typu.
Funkcja sum(X) zgłosi wyjątek integer overflow jeżeli suma dodawanych wartości typu INETEGER przekroczy maksymalną wartość dla tego typu. Funkcja total() nigdy nie zgłasza błędów.
Funkcje okien można stosować w wyrażeniach w instrukcjach SELECT.
Składnia: For clauses with first_value, last_value, nth_value and lag:
function-name(argument-list) [RESPECT NULLS | IGNORE NULLS] OVER ( [ PARTITION BY partition-expr-list ] [ ORDER BY sort-expr-list ] [ ROWS window-frame ])
For clauses with the remaining window functions and aggregate functions used as window functions:
function-name(argument-list) OVER ( [ PARTITION BY partition-expr-list ] [ ORDER BY sort-expr-list ] [ window-frame ])

partition-expr-list:
expression[, expression]*

window-frame:
BETWEEN UNBOUNDED PRECEDING AND [ UNBOUNDED FOLLOWING | CURRENT ROW ] |
UNBOUNDED PRECEDING
Funkcje okien, podobnie jak funkcje agregujące, działają jednocześnie na wielu wierszach (lub grupach wierszy) w zbiorze danych wynikowych. Różnice polegają na tym, że wiersze wykorzystywane do obliczenia wartości funkcji są określane przez klauzulę PARTITION BY (a nie GROUP BY); dodatkowe, funkcje okien mogą być wrażliwe na kolejność przetwarzania wierszy określoną przez klauzulę ORDER BY.
Klauzula PARTITION BY określa podział wierszy na partycje, dla których obliczana będzie wartość funkcji. Każdy unikalna kombinacja wartości wyrażeń w tej klauzuli określa jedną partycję. Brak klauzuli PARTITION BY oznacza, że wszystkie wiersze należą do tej samej grupy.
Klauzula ORDER BY określa, w jakiej kolejności wiersze z danej grupy mają być przetwarzane przez funkcję. Zob. także opis klauzuli ORDER BY w instrukcji SELECT.
Klauzule PARTITION BY i ORDER BY określają kolejność wierszy w tabeli wynikowej: w pierwszym kroku o kolejności decyduje podział na grupy, a w każdej grupie wiersze są ustawione w kolejności określonej przez ORDER BY. Nie należy jednak zakładać, że ta własność nie ulegnie zmianie w przyszłych wersjach bazy GDBase. W związku z tym najlepiej stosować jawną klauzulę ORDER BY dla całej instrukcji SELECT w celu otrzymania wierszy wynikowych w określonej kolejności.
Klauzula ROWS określa tzw. okno, czyli ciągły podzbiór partycji, na którym działa funkcja okien. Można określić następujące rodzaje okien:
- ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING
- Okno rozpoczyna się od pierwszego wiersza partycji i kończy się na ostatnim. Jest to domyślny rodzaj okna.
- ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
- Okno rozpoczyna się od pierwszego wiersza partycji i kończy się na bieżącym wierszu. Ten rodzaj okna można stosować tylko z funkcjami agregującymi.
- ROWS UNBOUNDED PRECEDING
- Takie określenie okna jest jednoznaczne z ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW.
Klauzulę IGNORE NULLS można stosować z funkcjami first_value, last_value, nth_value i lag. Sprawia ona, że przy obliczaniu wartości funkcji nie są uwzględnianie te wiersze, dla których argument funkcji przyjmuje wartość Nullx. Klauzula RESPECT NULLS sprawia, że wartości Null będą brane pod uwagę przy obliczaniu wartości funkcji. Użycie tych klauzul z innymi funkcjami skutkuje błędem.
Stosowanie kilku funkcji okien w jednej instrukcji SELECT
Użycie kilku funkcji okien w jednej instrukcji SELECT jest możliwe, o ile spełnione będą pewne warunki dotyczące konstrukcji klauzul OVER:
Jeżeli najdłuższa (czyli zawierająca najwięcej wyrażeń) klauzula OVER jest postaci
OVER ( PARTITION BY expr_1, expr_2, ... , expr_k ORDER BY expr_k+1, expr_k+2, ... , expr_m )
to każda inna klauzula OVER w danej instrukcji SELECT musi być postaci
OVER ( PARTITION BY expr_1, expr_2, ... , expr_l ORDER BY expr_l+1, expr_l+2, ... , expr_n )
przy czym n jest nie większe niż m.
Przykładowo, następujący sposób użycia funkcji okien jest poprawny:
SELECT ...
rank() OVER ( PARTITION BY a, b, c ORDER BY d, e ),
rank() OVER ( PARTITION BY a, b, c, d ORDER BY e ),
rank() OVER ( PARTITION BY a, b ORDER BY c, d )
...
Natomiast każda z poniższych konstrukcji spowoduje błąd:
SELECT ...
rank() OVER ( PARTITION BY a ORDER BY b ),
rank() OVER ( PARTITION BY b ORDER BY a )
...
SELECT ...
rank() OVER ( PARTITION BY a, b ORDER BY c ),
rank() OVER ( PARTITION BY b ORDER BY c )
...
W GDBase dostępne są następujące funkcje okien:
-
first_value(expression)
Zwraca pierwszą wartość wyrażenia w oknie. Funkcję można stosować z klauzulami IGNORE NULLS | RESPECT NULLS.
-
last_value(expression)
Zwraca ostatnią wartość wyrażenia w oknie. Funkcję można stosować z klauzulami IGNORE NULLS | RESPECT NULLS.
-
nth_value(expression, N)
Zwraca N-tą wartość wyrażenia w oknie, lub Null jeśli okno zawiera mniej niż N wierszy. Funkcję można stosować z klauzulami IGNORE NULLS | RESPECT NULLS.
-
lag(expression, K[, default_value])
Zwraca wartość wyrażenia obliczoną dla K-tego wiersza poprzedzającego bieżący wiersz w danej partycji, lub default_value (domyślnie Null, jeżeli przed bieżącym wierszem jest mniej niż K wierszy. Funkcję można stosować z klauzulami IGNORE NULLS | RESPECT NULLS.
-
row_number()
Zwraca numer wiersza w partycji zgodnie z kolejnością ustaloną przez klauzulę ORDER BY. Pierwszy wiersz ma numer 1.
-
rank()
Zwraca numer bieżącego wiersza w partycji pomniejszony o liczbę poprzedzających wierszy, w których wszystkie wyrażenia występujące w klauzuli ORDER BY przyjmują takie same wartości.
-
dense_rank()
Funkcja ta grupuje kolejne wyrażenia według kombinacji wartości wyrażeń w klauzuli ORDER BY, kolejnym grupom przypisuje kolejne liczby naturalne począwszy od 1, zgodnie z ustaloną kolejnością. Zwraca tak przypisany numer grupy.
-
percent_rank()
Zwraca znormalizowaną wartość obliczaną przez funkcję rank, zgodnie ze wzorem
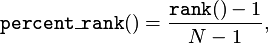
gdzie
 oznacza liczbę wszystkich wierszy w partycji.
-
cume_dist()
Zwraca wartość dystrybuanty, w zależności od kombinacji wartości wyrażeń w klauzuli ORDER BY, zgodnie ze wzorem
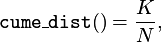
gdzie
 oznacza liczbę wierszy, których rank jest taki sam
lub mniejszy niż dla danego wiersza, a
 to całkowita liczba wierszy w partycji.
-
ntile(K)
Za pomocą tej funkcji można łatwo podzielić partycję na K podzbiorów o zbliżonych rozmiarach. Podział następuje zgodnie z ustaloną kolejnością wierszy. Funkcja zwraca numer podzbioru, do którego wpada dany wiersz.
Jeżeli
 oznacza liczbę wierszy w partycji i
 ,
to pierwsze
 podzbiorów zawiera po
 wierszy, a pozostałe zawierają po
 wierszy.
- funkcje agregujące jako funkcje okien
Każda funkcja agregująca może być również wykorzystana jako funkcja okien. O ile teoretycznie wartości zwracane przez funkcje agregujące nie zależą od kolejności wierszy, praktycznie zwracana wartość może zależeć od kolejności wierszy z uwagi na błędy arytmetyki zmiennoprzecinkowej.
Następujące funkcje agregujące można stosować ze słowem kluczowym DISTINCT w klauzuli OVER: sum, total, avg, count, stdev, variance, oraz funkcje obliczające kwantyle bez wag.
Przykład 33.38. Funkcja rank
table 'customer_transactions_1':
    customer_id  amount rebate
    1            200    20
    2            300    20
    2            300    20
    1            200    15
    1            50     0
    2            150    10
    1            200    15
    2            300    25
    1            50     5
    1            200    20
    1            50     0

sql t:
    SELECT customer_id, amount, rebate,
    rank() OVER ( PARTITION BY customer_id ORDER BY amount, rebate ) AS rank,
    dense_rank() OVER ( PARTITION BY customer_id ORDER BY amount, rebate ) AS dense_rank,
    percent_rank() OVER ( PARTITION BY customer_id ORDER BY amount, rebate ) AS percent_rank,
    cume_dist() OVER ( PARTITION BY customer_id ORDER BY amount, rebate ) AS cume_dist
    FROM customer_transactions_1

print t
Output:
customer_id | amount | rebate | rank | dense_rank | percent_rank       | cume_dist           |
+-----------+--------+--------+------+------------+--------------------+---------------------+--
          1 |     50 |      0 |    1 |          1 |                0.0 |  0.2857142857142857 |
          1 |     50 |      0 |    1 |          1 |                0.0 |  0.2857142857142857 |
          1 |     50 |      5 |    3 |          2 | 0.3333333333333333 | 0.42857142857142855 |
          1 |    200 |     15 |    4 |          3 |                0.5 |  0.7142857142857143 |
          1 |    200 |     15 |    4 |          3 |                0.5 |  0.7142857142857143 |
          1 |    200 |     20 |    6 |          4 | 0.8333333333333334 |                 1.0 |
          1 |    200 |     20 |    6 |          4 | 0.8333333333333334 |                 1.0 |
          2 |    150 |     10 |    1 |          1 |                0.0 |                0.25 |
          2 |    300 |     20 |    2 |          2 | 0.3333333333333333 |                0.75 |
          2 |    300 |     20 |    2 |          2 | 0.3333333333333333 |                0.75 |
          2 |    300 |     25 |    4 |          3 |                1.0 |                 1.0 |
Przykład 33.39. Obliczanie średniej wartości transakcji dla klienta za pomocą funkcji avg.
table 'customer_transactions_2':
    customer_id transaction_id transaction_amount
    1           1              100
    2           1              100
    1           2              500
    3           1              300
    1           3              50
    2           2              100
    2           3              100
    3           2              150
    1           4              1500
    2           4              50
    3           3              400
    3           4              1200
    1           5              100
    2           5              1500

sql t:
    SELECT customer_id, transaction_id, transaction_amount,
    avg(transaction_amount) OVER ( PARTITION BY customer_id ) AS average_transaction
    FROM customer_transactions_2

print t
Output:
customer_id | transaction_id | transaction_amount | average_transaction |
+-----------+----------------+--------------------+---------------------+--
          1 |              1 |                100 |               450.0 |
          1 |              2 |                500 |               450.0 |
          1 |              3 |                 50 |               450.0 |
          1 |              4 |               1500 |               450.0 |
          1 |              5 |                100 |               450.0 |
          2 |              1 |                100 |               370.0 |
          2 |              2 |                100 |               370.0 |
          2 |              3 |                100 |               370.0 |
          2 |              4 |                 50 |               370.0 |
          2 |              5 |               1500 |               370.0 |
          3 |              1 |                300 |               512.5 |
          3 |              2 |                150 |               512.5 |
          3 |              3 |                400 |               512.5 |
          3 |              4 |               1200 |               512.5 |