Spis treści
Grupowanie (ang. clustering) jest zagadnieniem podziału danych na klasy obserwacji podobnych do siebie w ramach klasy, a różniących się pomiędzy klasami. Początkowo zakłada się, że dane mogą zostać podzielone na pewną liczbę klas (inaczej: klasterów, ang. clusters). Następnie określane są położenie i rozmiar klasterów. Algorytm określa położenie centroidów klasterów na drodze minimalizacji sumy kwadratów odległości między nimi a obserwacjami. Algorytm k-średnich jest metodą heurystyczną, która zwraca wynik poprawny (ale nie zawsze optymalny).
Grupowanie metodą k-średnich jest algorytmem iteracyjnym tworzącym zadaną liczbę klasterów przy zachowaniu następujących wymagań:
Centroid każdego klastera jest średnią z obserwacji należących do tego klastera.
Każda obserwacja należy do jednego i tylko jednego klastera.
Ponieważ wyniki algorytmu k-średnich silnie zależą od inicjalnych centroidów, rekomenduje się przeprowadzić więcej niż jedno grupowanie na analizowanym zbiorze danych. Klasyczny algorytm k-średnich zapewnia mniej więcej 72% prawdopodobieństwo uzyskania optymalnego wyniku (warunkiem jest losowy wybór inicjalnych centroidów). Używany może być również wariant algorytmu, w którym zakłada się, że inicjalne centroidy znajdują się w centrum przestrzeni wyznaczonej przez obserwacje. Jest to wariant wolniejszy, ale zapewniający lepsze rezultaty.
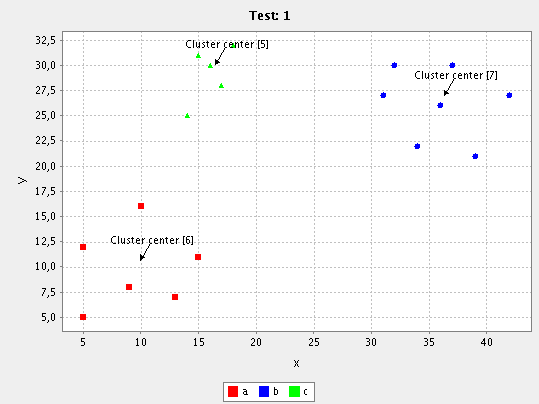
Algorytm k-średnich jest metodą bez nadzorowania.