Binarny target dzieli dane w zbiorze uczącym na dwie podgrupy. Celem liniowej funkcji dyskryminacyjnej jest konstrukcja estymatora, który na podstawie zmiennych objaśniających ma za zadanie przewidzieć, czy dana obserwacja jest z pierwszej czy z grupiej podgrupy (jaką ma wartość targetu).
Niech
 będzie wektorem zmiennych objaśniających (dla pojedynczej obserwacji).
Binarna liniowa funkcja dyskyminacyjna:
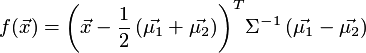
gdzie
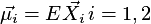 są wektorami średnich wartości
zmiennych objaśnianych w obu podgrupach i
 jest macierzą kowariancji obu podgrup, definiowaną jako
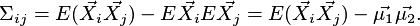
Wykorzystując liniową wartości funkcji dyskryminacyjnej, konstruowana jest funkcja klasyfikacyjna, która pozwala na przypisanie do jednej z dwóch podgrup (klas):
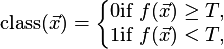
gdzie T jest progiem odcięcia klasyfikacji zdefiniowanym jako:
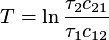
,
 jest a-priori danej podgrupy w danych uczących
(udział procentowy danej podgrupy), a
 jest kosztem błędnej klasyfikacji, czyli błędnie
przypisanej obserwacji z pogdupy i do podgrupy j.
Taki koszt może być określany w
Ustawienia_Algorytmu (AlgorithmSettings).
Analiza dyskryminacyjna jest typowym przykładem gdzie dane uczące zbudowane są z dwóch populacji opisanych za pomocą zmiennych objaśniających. W procesie modelowania zakłada się, że istnieją zmienne objaśniane dla których wartości średnie pomiędzy podgrupami różnią się. Podstawowym założeniem budwy modelu dyskryminacyjnego, w odróżnieniu od modelu regresji logistycznej jest założenie o tym że zmianne objaśniane mają rozkład normalny.
Innym istotnym założeniem modelu liniowego jest, że macierze kowariancji zmiennych objaśniających w obu podgrup są równe. To założenie to w ogólnym przypadku nie jest spełnione, więc ustawienia algorytmu umożliwiają wybór pomiędzy macierzą kowariancji pierwszej podgrupy, macierzą kowariancji drugiej podgrupy lub średnią z dwóch macierzy.
Jesli założenie o rozkładzie normalnym nie jest spełnione użytkownik może użyć model regresji logistycznej. Z drugiej strony jeśli oba powyższe założenia utrzymać, binarny model dyskryminacyjny powinien być bardziej efektywny w klasyfikacji uwzględniając poziom błędów klasyfikacji.