Niniejszy rozdział przedstawia koncepcję obiektowego podejścia do procesu Data Mining, które jest podstawą całej pracy w systemie AdvancedMiner.
Proces Data Mining w systemie AdvancedMiner definiuje się poprzez szereg obiektów metadanych.
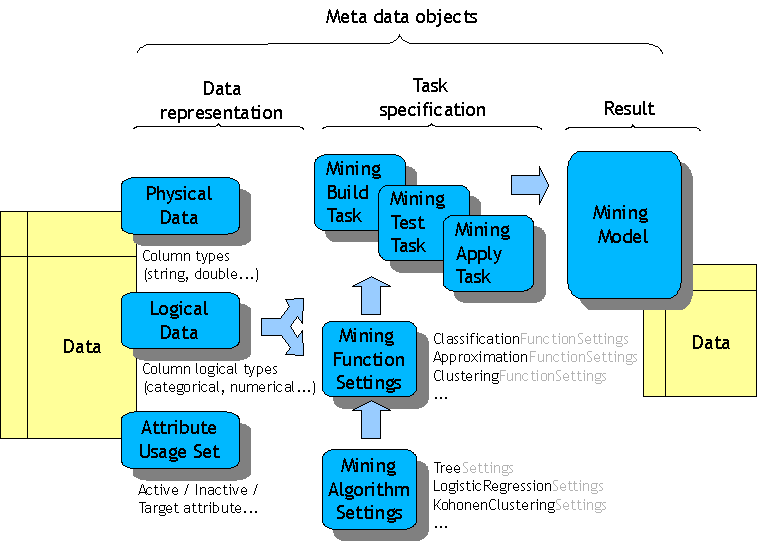
Każdy z tych obiektów reprezentuje określoną część procesu:
Reprezentacja danych
Do reprezentacji danych służą następujące obiekty: PhysicalData, LogicalData oraz AttributeUsageSet. Przechowują one informacje na temat lokalizacji danych, ich fizycznej struktury, typów i.in.
Specyfikacja zadania
Zarządzanie zadaniem: Tasks
Istnieje szereg obiektów służących sterowaniu procesami Data Mining takimi jak: budowa modelu (MiningBuildTask), testowanie (np.: ClassificationTestTask, ApproximationTestTask) oraz aplikacja modelu do nowych danych (MiningApplyTask). Powiązane są one z innymi obiektami przechowującymi informacje o wykorzystanych danych i algorytmach. W wyniku uruchomienia obiektów zarządzających powstają obiekty z rezultatami.
Cel modelowania: Mining Function
Cel modelowania (Mining Function np.: classification, approximation, segmentation) definiowany jest poprzez obiekt MiningFunctionSettings.
Specyfikacja algorytmu: Algorithm Settings
Każdy obiekt typu Mining Function jest powiązany z konkretnym algorytmem realizującym budowane zadanie. Algorytm ten jest reprezentowany jako oddzielny obiekt (algorithmSettings), dzięki czemu możliwa jest jego podmiana bez konieczności podmiany pozostałych obiektów z nim powiązanych.
Każde zadanie Data Mining może być zrealizowane przez conajmniej jeden algorytm. Na przykład, zadanie klasyfikacji może korzystać z algorytmów takich jak: sieci neuronowe (FeedforwardNeuralNetSettings), regresja logistyczna (LogisticRegressionSettings) czy drzewa decyzyjne (TreeSettings). Z kolei aproksymacja może być zrealizowana przy pomocy: sieci neuronowych (FeedforwardNeuralNetSettings), regresji liniowej (LinearRegressionSettings) czy SVM (SVMSettings). Dla każdego algorytmu istnieje dodatkowo szereg parametrów decydujących o szczegółach działania algorytmu. Dla segmentacji i algorytmu k-means może to być na przykład docelowa liczba segmentów, które mają być zidentyfikowane.
Rezultaty
Uruchomienie niektórych zadań powoduje powstanie nowych obiektów przechowujących rezultaty. W przypadku MiningBuildTask powstaje obiekt reprezentujący zbudowany model. Oprócz szeregu informacji dotyczących ustawionych parametrów, obiekt ten może zawierać również statystyki związane ze zbudowanym modelem.
Notatka
Oprócz powyżej wymienionych, istnieją jeszcze inne obiekty, na przykład transformacje czy zadania z obszaru Data Quality. Zostały one opisane w rozdziale Repozytorium Metadanych.
Dla początkujących użytkowników Systemu AdvancedMiner obiektowa koncepcja pracy może z początku wydawać się skomplikowana. Jednakże takie podejście umożliwia analitykowi wprowadzanie dowolnych zmian w prosty i szybki sposób (np. zmiana algorytmu klasyfikacyjnego, porównywanie modeli) oraz pozostawia mu dużą swobodę zarówno na etapie przetwarzania jak i modelowania danych. Zalety takiego podejścia do pracy analitycznej stają się widoczne szczególnie w złożonych projektach Data Mining.