Drzewo jest zbiorem połączonych ze sobą węzłów. Pierwszy węzeł jest określany jako korzeń. Węzły połączone z dołu do danego węzła są nazywane jego węzłami potomnymi (dziećmi). Węzły bez potomków są nazywane liśćmi. Do każdego węzła, który nie jest liściem przypisany jest test. Idea testu jest opisana poniżej. Rozkład targetu, który jest traktowany jako decyzja, jest przypisany do każdego liścia. Krawędzie reprezentują możliwy rezultat testu zastosowanego dla wyższego węzła.
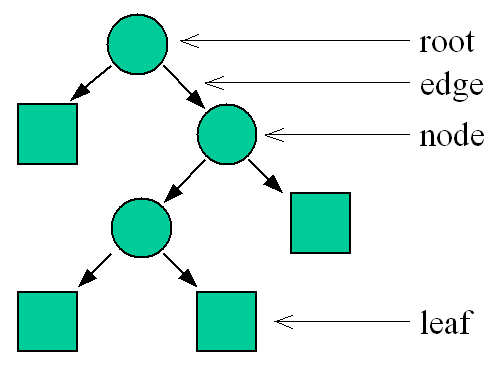
Dla danej obserwacji wyrażonej jako wektor danych wejściowych klasyfikacja jest wykonywana poprzez przechodzenie drzewa od korzenia do liścia. Klasyfikacja na każdym węźle opiera się na teści przypisanym do danego węzła. W zależności od wyniku testu dla danego wektora wejściowego, wybierany jest odpowiedni węzeł jest potomny. Powyższa procedura jest powtarzana do momentu osiągnięcia liścia. Decyzja o klasyfikacji jest podejmowana z wykorzystaniem liścia na którym procedura się zakończyła.
Test opiera się na analizie wartości atrybutu i przypisanie mu jednej z kategorii wynikowych. Wyróżniamy cztery rodzje testów w module Drzew Klasyfikacyjnych:
- numeric
Jest to test binarny. Wartość liczbowa atrybutu jest porównywana z wartością progową. Jeśli wartość jest większa lub równa wartości progowej, obserwacja przypisywana jest do prawego potomka, w przeciwnym przypadku przypisywana jest do lewego potomka.
- nominal binary
Jest to test binarny dla atrybutów kategorycznych. Testowana wartość jest porównywana z wybraną kategorią. Jeśli wartość jest równa wybranej kategorii, obserwacja przypisywana jest do prawego potomka, w przeciwnym przypadku przypisywana jest do lewego potomka.
- nominal - all values
Jest to test wielowartościowy dla atrybutów kategorycznych. Tworzonych jest tak dużo potomków, ile jest możliwych kategorii dla danego atrybutu. Każdy potomek odpowiada jednej wartości atrybutu.
- nominal - grouped
Test ten jest najbardziej ogólnym typem testów dla predykotrów kategorycznych. Może mieć dowolną liczbę węzłów potomnych. Każdy taki węzeł odpowiada grupie kategorii. Jeśli dana grupa zawiera wartość aktualnego atrybutu, wówczas obserwacja przypisywana jest do odpowiedniego węzła potomnego.
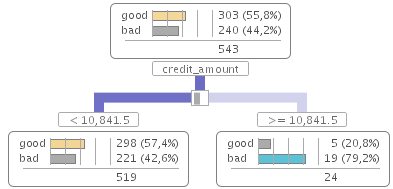
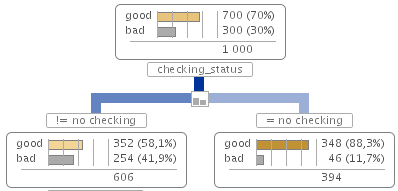
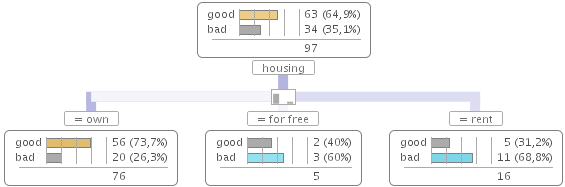
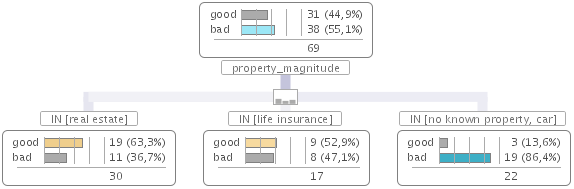
Moduł Drzew Klasyfikacyjnych w AdvancedMiner używa rekurencyjnego algorytmu budowania drzewa z góry na dół ("top-down").
Konstrukcja drzewa jest procesem rekurencyjnym wykorzystującym podział danych wejściowych. Główną zasadą jest wybór takich testów, które podzielą dane na podzbiory zawierające jak najbardziej homogeniczny target. Odpowiednia metoda oceny jest stosowana do porównania możliwych sposobów podziału i wybrania najlepszego z nich.
Gdy test na danym poziomie (węźle) jest wybrany, algorytm przechodzi w dół, zbiór danych jest dzielony zgodnie z testem, i procedura jest powtarzana dla każdego podzbioru.
Algorytm zatrzymuje sie w momencie, gdy spełniony jest jeden z kryteriów stopu.
W module Drzew Klasyfikacyjnych wyróżniamy cztery warunki, po spełnieniu których algorytm rekurencyjny zatrzyma się i utworzy liść (węzeł końcowy) w bieżącym węźle:
Stężenie przypadków z pewną kategorią zmiennej objaśnianej osiąga pewien poziom: wszystkie obserwacje należą do tej samej klasy lub warunek Homogeneous Density jest spełniony.
Wielkość węzła jest zbyt mała by kontynuować podział: warunek Min Node Size lub Min Node Size Prc nie jest spełniony lub w rozważanym węźle nie ma żadnych obserwacji.
Głębokość drzewa przekracza limit określony przez Max Tree Depth.
Brak jest odpowiednich testów. Tego typu sytuacja pojawia się, gdy wszystkie testy mają wartość oceny mniejszą niż 0 lub mniejszą niż wartość Min Split Evaluation Gain .
Notatka
Kryterium stopu dotyczy tylko fazy budowy drzewa. Oznacza to, że warunki na minimalny rozmiar węzła lub wysokość drzewa mogą nie być spełniane po procesie przycinania drzewa.
Algorytm wybiera najlepszy sposób podziału dla danego węzła poprzez ocenę wszystkich dostępnych testów, i wybór tego, dla którego wartość funkcji oceny jest największa. Uzyskiwane są wartości z przedziału [-1.0, 1.0). Dodatnia wartość oznacza, że podział oparty na danym teście będzie poprawiał efektywność klasyfikowania danych przez model. Wartość -1.0 oznacza, że podział nie jest poprawny. Ujemne wartości oznaczają pogorszenie efektywności klasyfikacji.
W AdvancedMiner zaimplementowane są trzy wyrażenia matematyczne, które są używane do wyliczenia wartości oceny dla danego testu. Wszystkie opierają się na analizie rozkładu zmiennej opisywanej w danym węźle i jego bezpośrednich węzłach potomnych.
Niech
 będzie zbiorem obserwacji w danym węźle,
 będzie ocenianym podziałem
zbioru
 natomiast
 będzie operatorem rozmiaru zbioru. Niech
 będzie częstością kategorii
targetu
 w zbiorze
 .
- Podział oparty na entropii
Entropia zbioru
 jest równa:
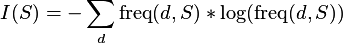
Przyrost entropii określamy jako różnicę pomiędzy entropią zbioru
 a entropią podziału. Entropia
podziału
 jest równa średniej ważonej
entropii z entropii podzbiorów:
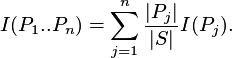
Ostatecznie, przyrost entropii
 jest równy
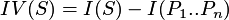 . Szczegółowy opis znajduje się w
Quinlan 1993, strony 20, 21, rozdział
"Gain criterion"
- Podział oparty na gainRatio
Współczynnik przyrostu (gainRatio) określamy jako przyrost entropii unormowany przez rozkład wielkości podzbiorów. Oznaczmy ten rozkład przez
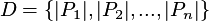 . Wówczas
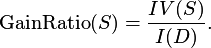
(Szczegółowy opis znajduje się w Quinlan 1993, strony 23, 24, rozdział "Gain ratiocriterion")
- Podział oparty na współczynniku Gini
Współczynnik Gini dla podzbioru
 jest wyznaczany z użyciem wyrażenia
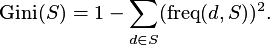
Wartość oceny podziału z użyciem współczynnika Gini jest wyznaczana za pomocą wyrażenia
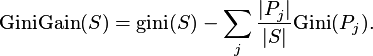
(Szczegółowy opis znajduje się w Breiman 1984, strona 93, rozdział "Splitting Rules")
Przycinanie jest procesem niezależnym, przeprowadzanym po całkowitym zbudowaniu drzewa. Jego celem jest zredukowanie rozmiaru drzewa. Pojedyncza operacja w procesie przycinania zastępuje dany węzeł liściem lub większym "poddrzewem". Operacja ta jest powtarzana rekurencyjnie od liści do korzenia (z dołu w górę).
Przycinanie zapewnia zmniejszenie poziomu przeuczenia. W efekcie redukowany jest błąd, który popełnia algorytm w każdym kroku procesu budowy drzewa na nowych danych.
W module Drzew Klasyfikacyjnych w AdvancedMiner stosowana jest metoda przycinania z pesymistycznym określaniem błędu. Metoda ta używa zbioru treningowego do pesymistycznej estymacji możliwego błędu, który klasyfikator popełni na nowych danych. Zbiór walidacyjny nie jest wykorzystywany w przycinaniu.
Braki danych są aktualnie całkowicie wspierane przez moduł Drzew Klasyfikacyjnych. Braki danych są obsługiwane dzięki użyciu metody podziału przypadków. (szczegółowy opis znajduje się w Quinlan 1993, rozdział "Unknown Attribute Values")