Niniejszy rozdział przedstawia przykład skorowania danych przy użyciu modelu klasyfikacyjnego w systemie AdvancedMiner. Wszystkie nazwy wymienione w cudzysłowie są przykładowymi nazwami obiektów.
Przed przystąpieniem do zadania skorowania danych niezbędne jest:
-
posiadanie w repozytorium modelu
- w tym celu warto zapoznać się z ModelBuildingGuide
- posiadanie w bazie danych tabeli z danymi do scoringu.
Założenie: w poniższym przykładzie zakładamy, że użytkownik posiada w repozytorium jedynie model, powstały w wyniku pewnego procesu modelowania.
W procesie skoringu wykorzystywane są następujące obiekty MR
- PhysicalData - dwa obiekty: jeden związany z danymi skorowanymi oraz drugi powiązany ze zbiorem wynikowym
- MiningApplyTask - obiekt definiujący zadanie skorowania
- model - wynik procesu budowy modelu
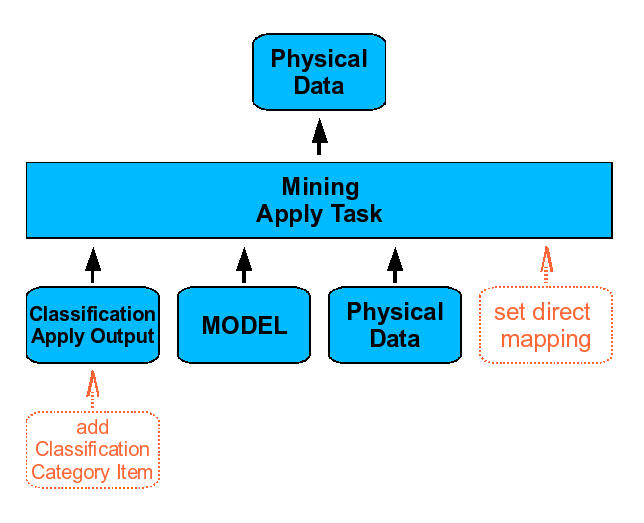
Zadanie stosowania modelu składa się z następujących kroków:
-
krok 1:
- tworzymy PhysicalData ('german_credit_pd')
- wskazujemy zbiór do scorowania: 'german_credit'
-
krok 2:
- tworzymy PhysicalData ('apply_results_pd')
- definiujemy nazwę dla zbioru wynikowego: 'apply_results'
- krok 3:
- tworzymy MiningApplyTask ('MiningApplyTask')
-
określamy cel zadania: aplikacja modelu
-
krok 3a:
- dodajemy ClassificationApplyOutput
-
wybieramy rodzaj
oczekiwanego wyniku: tutaj
wyniku klasyfikacji
-
krok 3a-i:
- item: dodajemy element
- we choose ClassificationCategoryItem and we define output variable named 'score' as probability for category 'bad'
-
krok 3a-i:
-
krok 3b:
- dodajemy model
- wskazujemy aplikowany model: 'MODEL'
-
krok 3c:
- add sourceData
- wskazujemy dane do scorowania poprzez wskazanie PhysicalData 'german_credit_pd'
-
krok 3d:
- dodajemy targetData
- wskazujemy zbiór wynikowy poprzez wskazanie PhysicalData 'apply_results_pd'
-
krok 3e:
- directMapping: dodajemy element
- dla zbioru wynikowego definiujemy kolumnę o nazwie 'real_target_value' jako kopię zmiennej 'Class' ze zbioru wejściowego
-
krok 3a:
- krok 4:
- wykonujemy zadanie 'MiningApplyTask'
Notatka
- Przedstawiony schemat postępowania jest wspólny dla wszystkich typów modeli. Różnice można napotkać przy definiowaniu konkretnych kolumn dla zbioru wynikowego - dostępne rodzaje są uzależnione od typu stosowanego modelu.
Jeżeli wszystko poprawnie udało się zdefiniować, w wyniku działania MiningApplyTask w bazie danych pojawi się zbiór zawierający dwie kolumny ( zobacz film ).
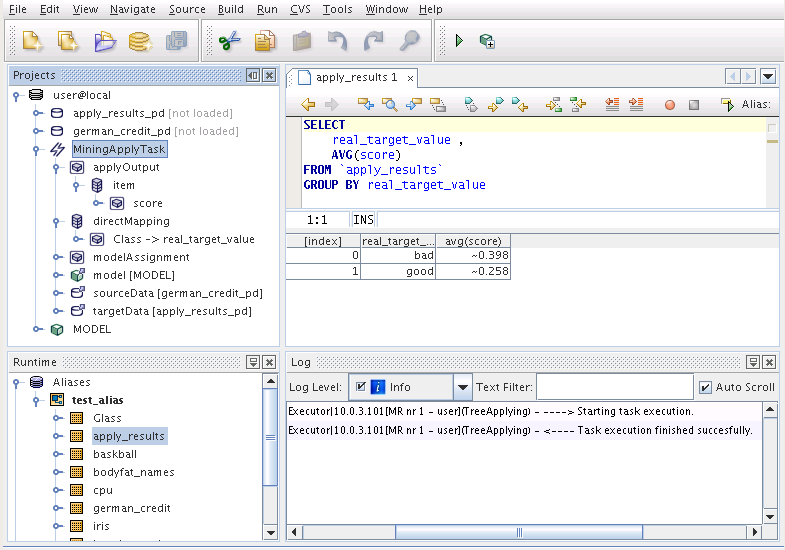
Wyżej przedstawione czynności można również wykonać w języku skryptowym.
Przykład 1.1. ModelApplying
#                                   MODEL APPLYING PROCESS
# -- zakładamy, że w repozytorium istnieje model, powstały w wyniku pewnego procesu modelowania

# krok 1 -- tworzymy i zapisujemy PhysicalData w repozytorium
#        -- wskazujemy zbiór do scorowania: 'german_credit'
PD = PhysicalData('german_credit')
save('german_credit_pd',PD)

# krok 2 -- tworzymy i zapisujemy PhysicalData w repozytorium
#        -- definiujemy nazwę dla zbioru wynikowego
PD = PhysicalData('apply_results')
save('apply_results_pd',PD)

# krok 3 -- tworzymy MiningApplyTask
#        -- określamy cel zadania: aplikacja modelu
MAT = MiningApplyTask()

# krok 3a -- MiningApplyTask: dodajemy applyOutput -->> ClassificationApplyOutput
#         -- wybieramy rodzaj oczekiwanego wyniku: tutaj wyniku klasyfikacji
CAO = ClassificationApplyOutput()

# krok 3a-i-- MiningApplyTask -> ClassificationApplyOutput -> item: dodajemy element -->> ClassificationCategoryItem
#          -- definiujemy nową kolumnę o nazwie 'score', w której znajdzie się prawdopodobieństwo dla kategorii 'bad'
CCI_score = ClassificationCategoryItem('score' , ClassificationOutputType.probability , 'bad')
CAO.item.add ( CCI_score )

# dołączamy ClassificationApplyOutput do MiningApplyTask
MAT.setApplyOutput(CAO)

# krok 3b -- MiningApplyTask: dodajemy model
#         -- wskazujemy aplikowany model
MAT.setModelName('MODEL')

# krok 3c -- MiningApplyTask: dodajemy sourceData
#         -- wskazujemy dane do scorowania
MAT.setSourceDataName('german_credit_pd')

# krok 3d -- MiningApplyTask: dodajemy targetData
#         -- wskazujemy zbiór wynikowy
MAT.setTargetDataName('apply_results_pd')

# krok 3e -- MiningApplyTask -> directMapping: dodajemy element
#         -- dla zbioru wynikowego definiujemy kolumnę o nazwie 'real_target_value' jako kopię zmiennej  'Class' ze zbioru wejściowego
ASI_real_target_value = ApplySourceItem('Class','real_target_value')
MAT.directMapping.add( ASI_real_target_value )

# kroki 3,3a,3a-1,3b,3c,3d,3e -- zapisujemy zadanie MainingApplyTask w repozytorium
save('MiningApplyTask',MAT)

# krok 4 -- wykonujemy zadanie 'MiningApplyTask'
execute('MiningApplyTask')

print "Done..."
Output:
Done...